AI-агенты

[Перевод] Строим продвинутый каркас для ИИ-агента
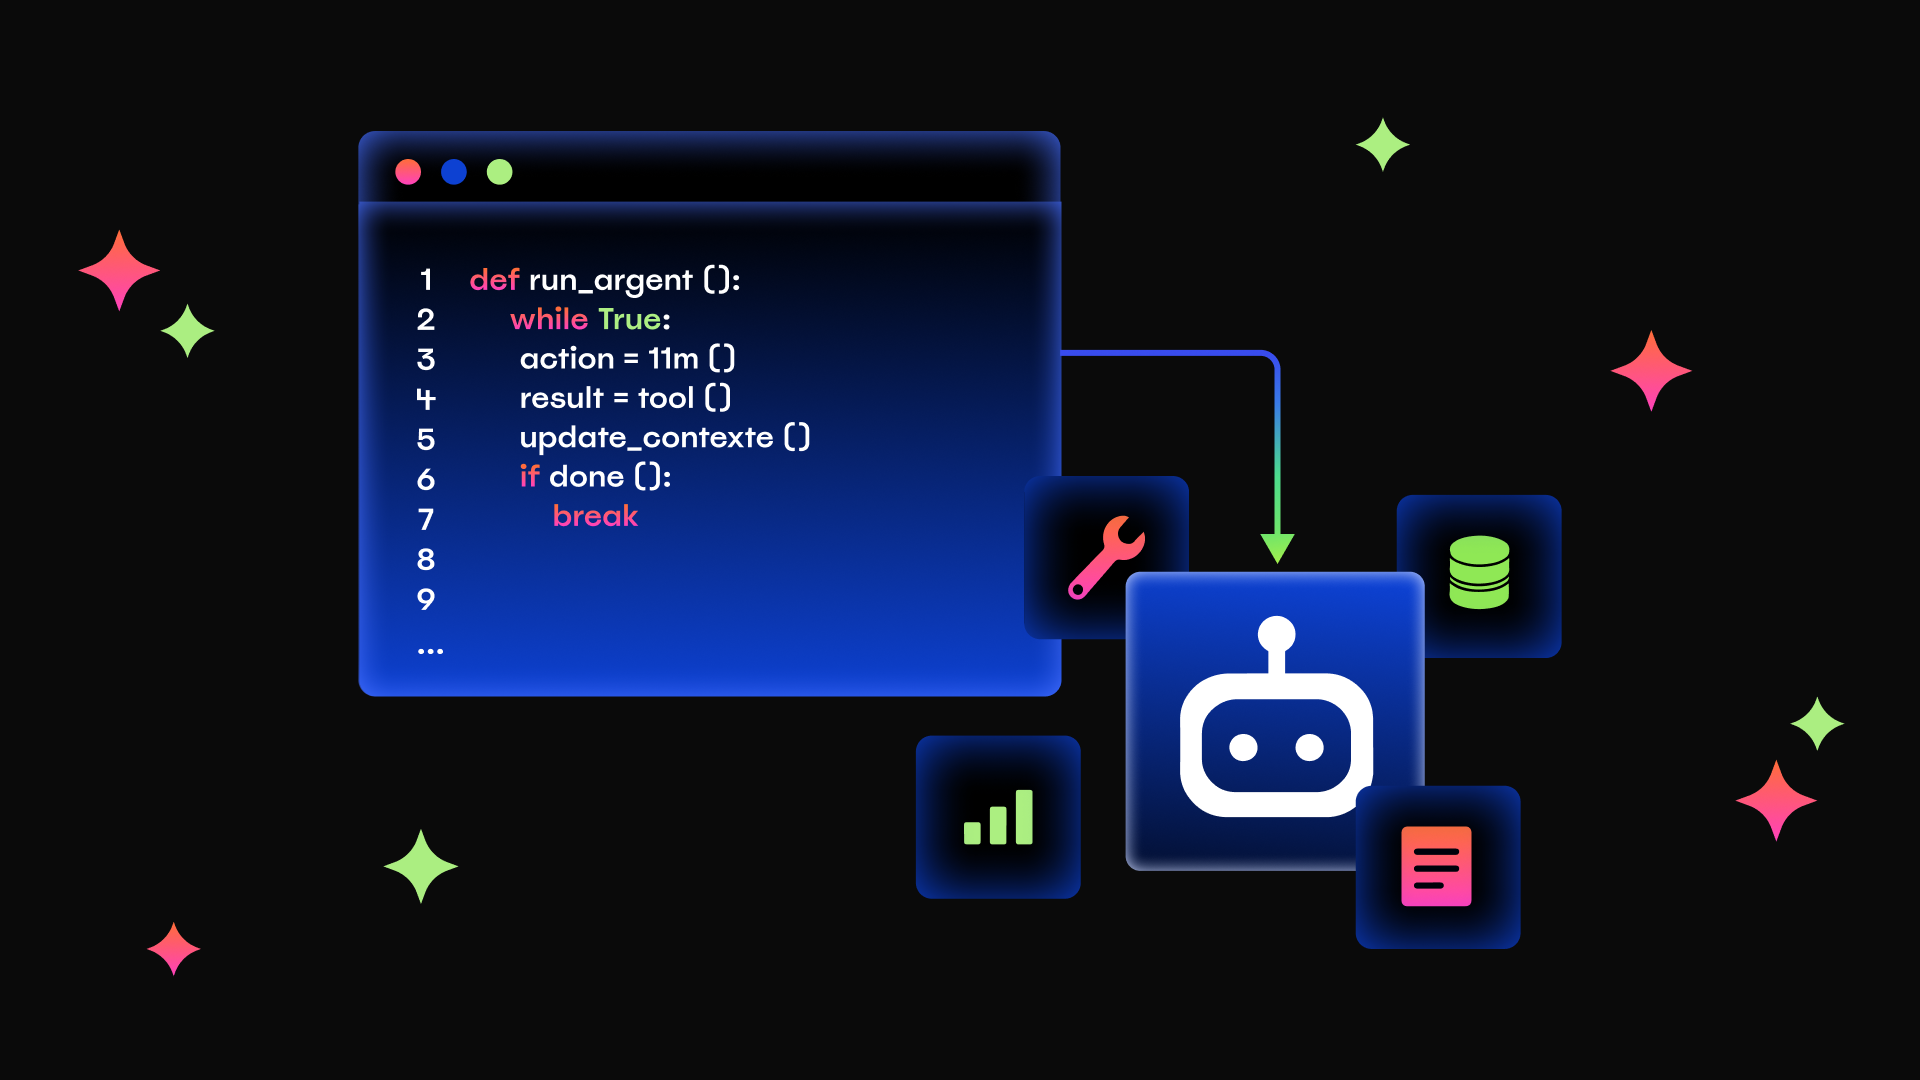
Обложка: [Перевод] Строим продвинутый каркас для ИИ-агента
В основе базового agentic harness — простой цикл: LLM получает задачу, выбирает и вызывает инструмент, результат возвращается в контекст, после чего модель решает, какое действие выполнить следующим. Цикл продолжается, пока модель не решит, что задача выполнена. Этот цикл корректен, но наивен. Один пилот на хорошем истребителе вполне может выиграть воздушный бой, но никто не ведёт так целую воздушную операцию. В реальных операциях есть планировщики миссий, которые ещё до взлёта определяют, какие вылеты предстоит выполнить; эскадрильи, параллельно выполняющие независимые задачи; топливные лимиты и сигнал bingo fuel, после которого нужно возвращаться на базу; бортовые самописцы, позволяющие восстановить ход каждого вылета; наконец, разборы после выполнения, на которых определяют, была ли миссия действительно успешной. Ничто из этого не заменяет пилота.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

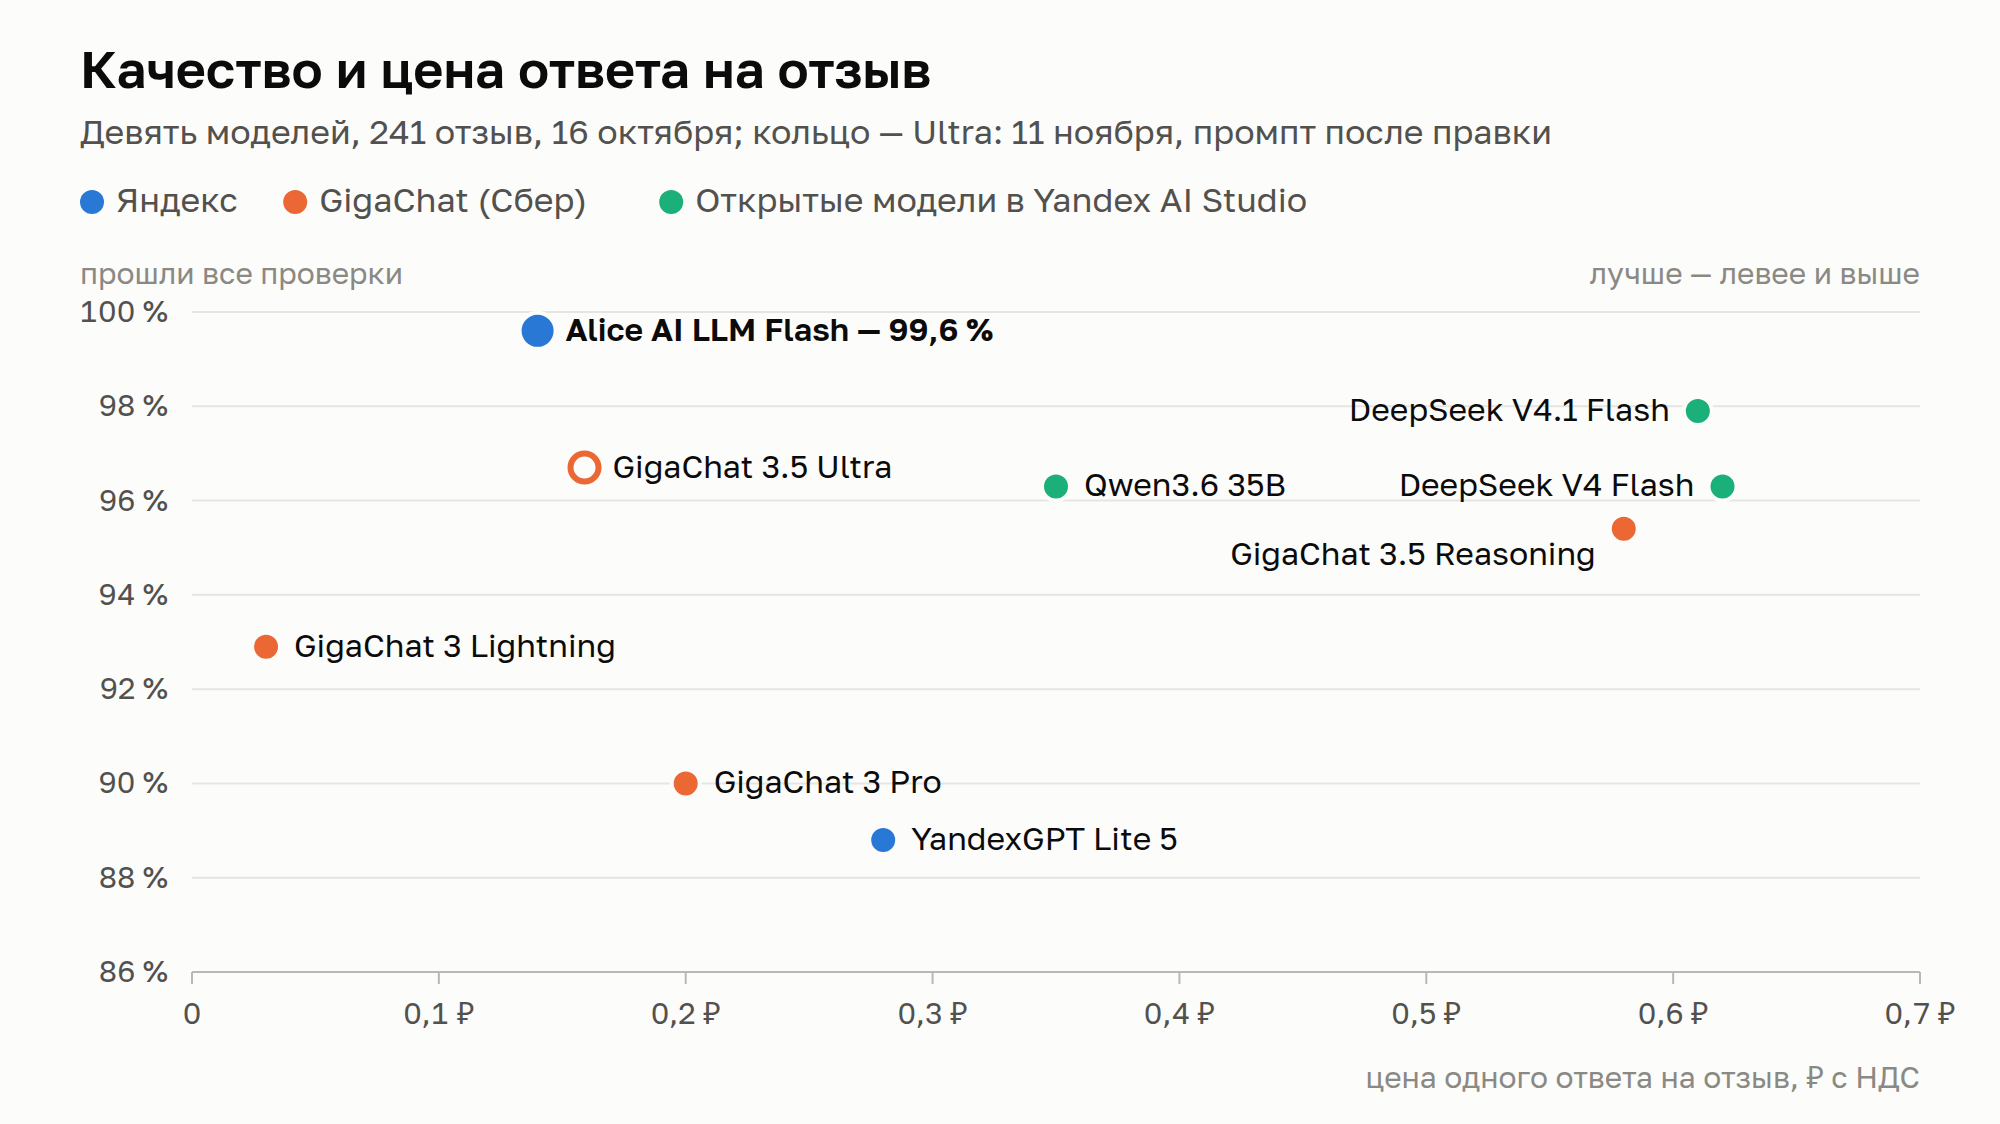
Обложка: Тринадцать LLM на русских отзывах: как я выбирал модель и почему не поверил судье
AI-агентыHabr AI

Тринадцать LLM на русских отзывах: как я выбирал модель и почему не поверил судье

Я делаю сервис, который отвечает на отзывы покупателей на Wildberries, Ozon и Яндекс Маркете. Покупатель пишет, что часы встали через три дня, а модель с самым серьёзным видом отвечает: «Передадим замечание на производство для проверки партии». Никакую партию никто проверять не будет. Я сравнил тринадцать моделей — Alice AI LLM Flash, YandexGPT Pro 5.1 и Lite 5, семь GigaChat, два DeepSeek и Qwen — на синтетических отзывах и вопросах, где для каждого примера заранее записано, что считается правильным ответом. Внутри: как и почему модели выдумывают обещания, парный бутстрап, регулярка против «проверки партии», LLM-судья, которому нельзя верить на слово, и почему резерв пришлось выбирать отдельно для каждой задачи. Читать разбор

AI-агентыHabr AI

[Перевод] Как ускорить локальную LLM на 50% без покупки новой видеокарты

На GTC Berlin 2026 участники воркшопа NVIDIA смогли ускорить генерацию Qwen3-32B с 16,4 до 24,5 токена в секунду, не меняя оборудование. Для этого использовали FP8 вместо BF16. Общая пропускная способность тоже выросла, хотя и заметно меньше: с 639 до 719 токенов в секунду. Эксперимент проводили на Kubernetes-кластере с четырьмя NVIDIA A100 по 80 ГБ. У каждого участника был собственный кластер, на котором можно было разворачивать модели, менять конфигурацию и измерять производительность. Помимо квантизации, на занятии разбирали NVIDIA Dynamo, маршрутизацию запросов с учётом KV-кеша, автоматическое масштабирование и разделение prefill/decode между GPU. Материал основан на статье инженера Siim Tolk, опубликованной 4 ноября 2026 года.

Обложка: Живое ТЗ и храповик: как заставить ИИ-агента не ломать то, что работает
AI-агентыHabr AI

Живое ТЗ и храповик: как заставить ИИ-агента не ломать то, что работает

TL;DR. Пять месяцев ИИ-агент пишет производственное планирование для завода, который раньше жил в Excel. Я не читаю код вообще. Контроль вынесен в четыре вещи: правила, которые агент читает перед каждой задачей; тесты как контракт к каждому жёсткому правилу; храповик, который не даёт тестам слабеть молча; и ТЗ, которое растёт вместе с эксплуатацией. Это всё по отдельности не ново, но агент держит всё это вместе, синхронно при каждой правке. В командах людей обычно такой синхрон рассыпается на втором месяце. Ниже цифры за пять месяцев, включая набитые шишки и два случая, где модели попроще разобрали те же задачи, что и Opus: каждая сторона нашла то, что пропустила другая.