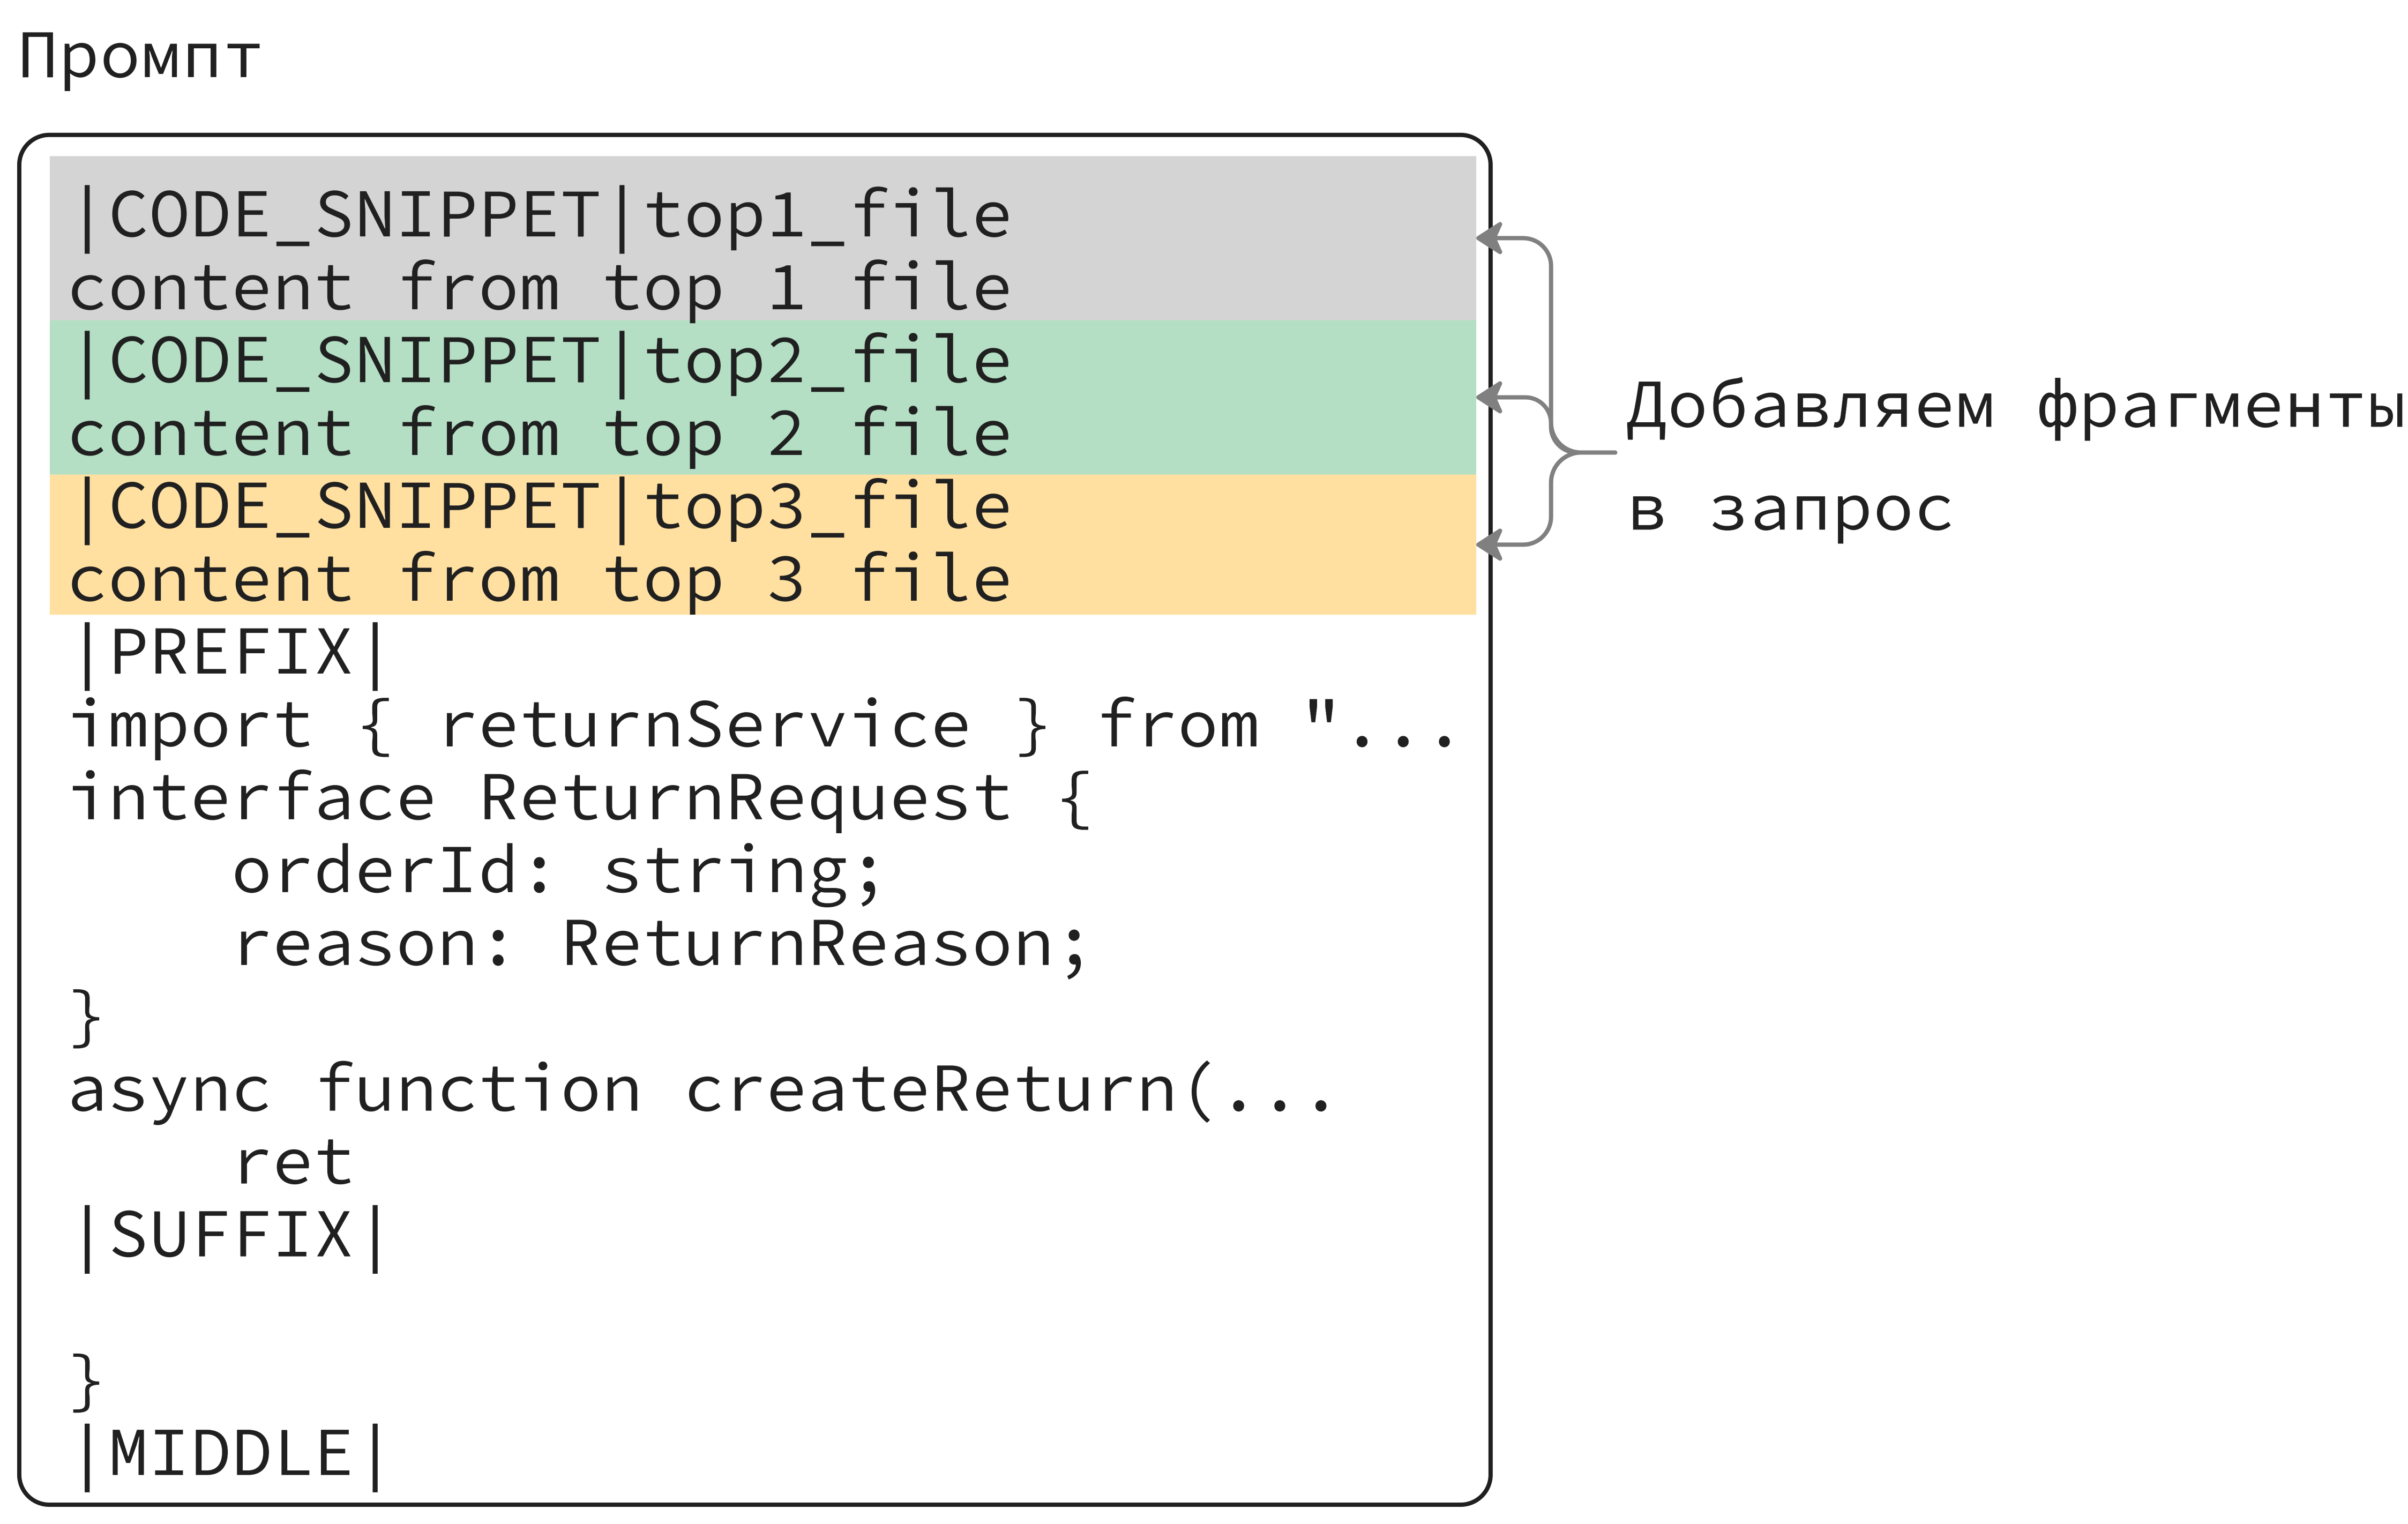
Продолжаем разбирать, как система автодополнения собирает контекст для LLM. В реальном репозитории потенциально полезных файлов слишком много, поэтому мало просто найти фрагменты с похожими словами - нужно понять, какие из них действительно стоит показать модели. Разберём один из классических алгоритмов ранжирования - BM25: почему редкие идентификаторы важнее популярных слов, зачем учитывать размер файла и почему десять одинаковых совпадений не должны быть в десять раз полезнее одного. Читать заметку
Читать далееAI-агенты
[3/8] Context Ranking: как выбрать полезные фрагменты из репозитория