AI-агенты

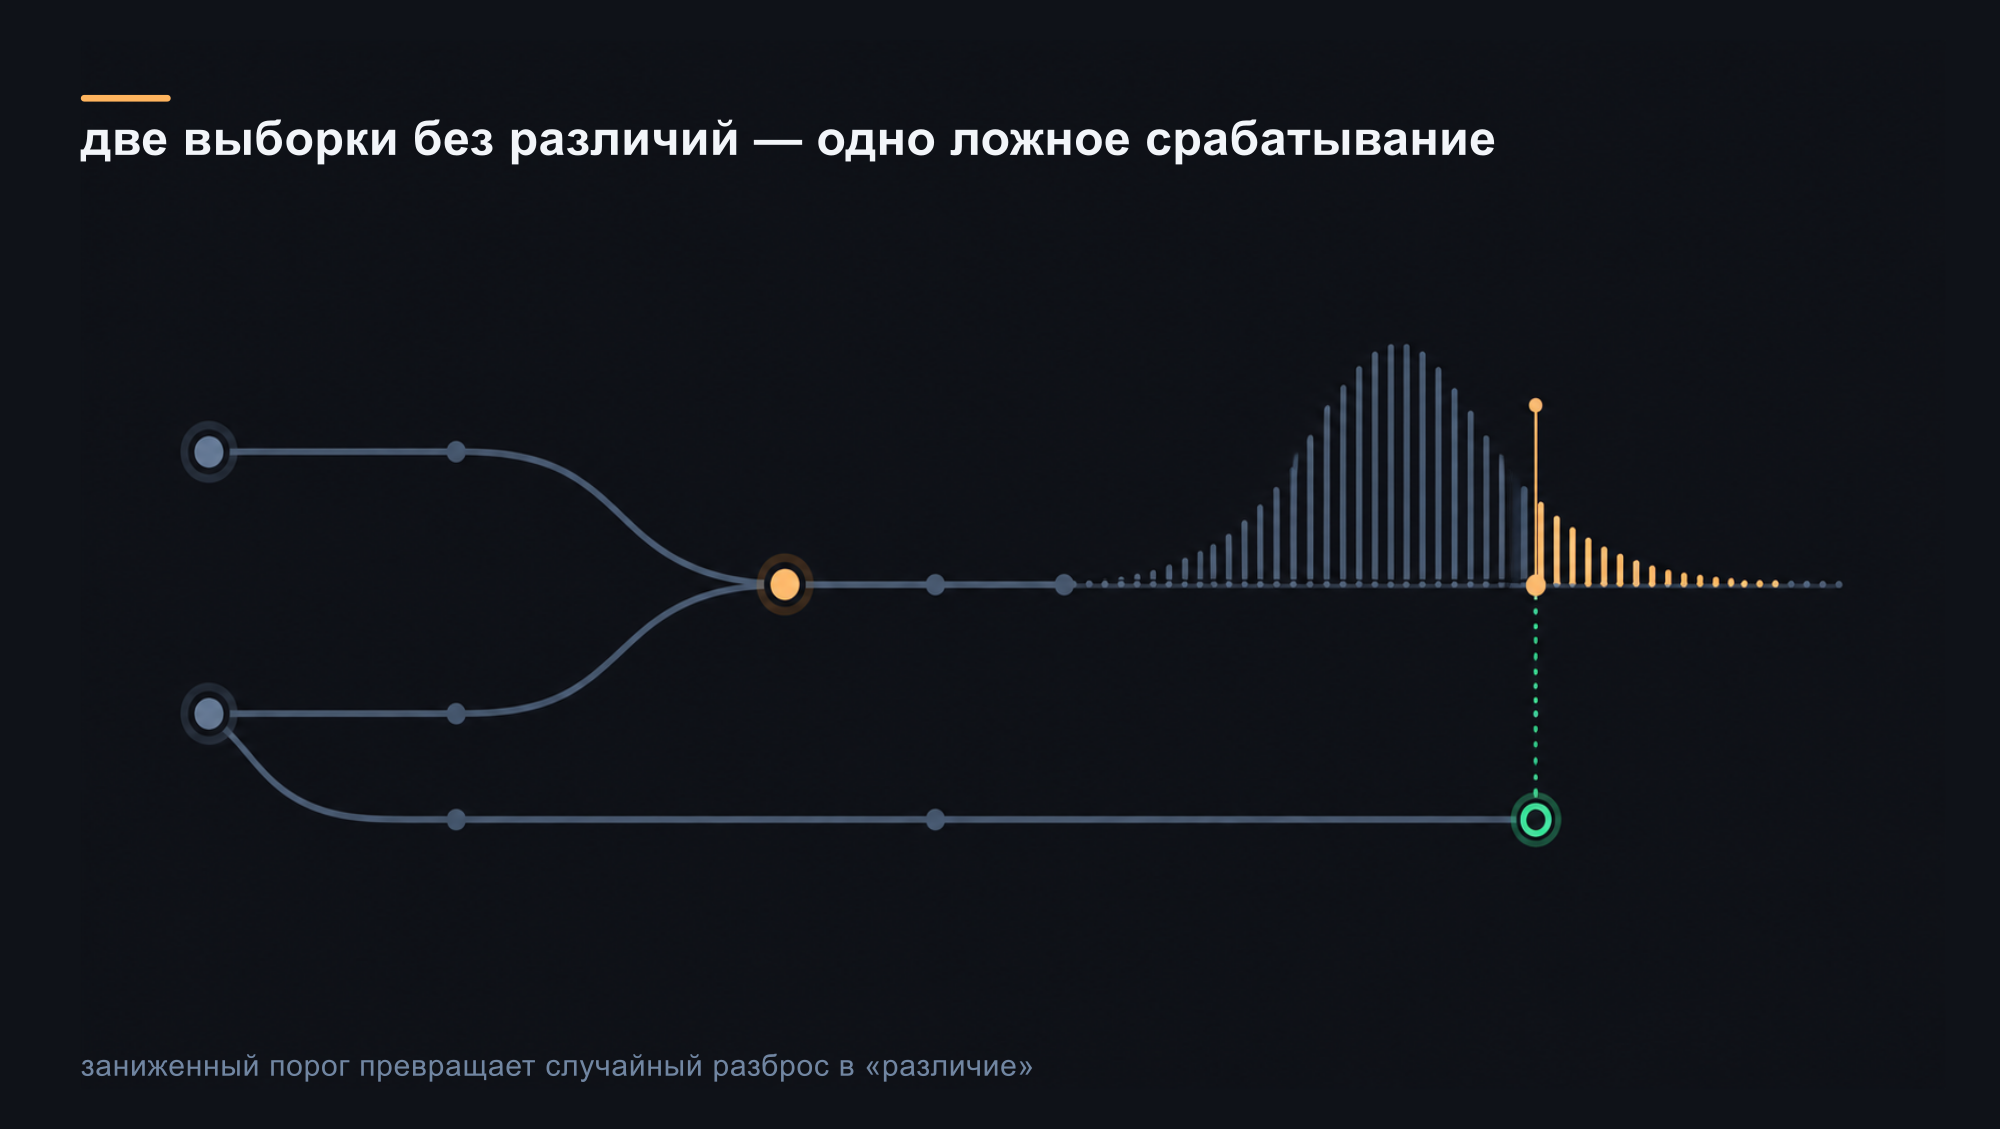
A/A на страже: как статистический тест находит различие, которого нет
Обложка: A/A на страже: как статистический тест находит различие, которого нет

В прошлой статье я разбирал спекулятивное декодирование — способ ускорить языковую модель. Метод обещает, что ускорение не изменит ответы: распределение текстов на выходе останется ровно таким же, как при обычной генерации. Гарантия следует из самого устройства метода, но её стоило проверить на практике. Первая попытка дала обратный результат: статистический тест уверенно сообщал, что распределения различаются. Ошибка сидела не в модели и не в ускорении, а в самом тесте. По одному выводу её было не разглядеть: числа выглядели нормально. Эта статья о том, как статистический тест может показать различие там, где его нет, и как такую поломку отловить. Языковые модели тут ни при чём: такая же поломка случается и в A/B-тесте, в проверке после квантизации и в регрессионном тесте, который сравнивает распределение времени ответа до и после релиза.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Sandflow открыла датасет из 106 тысяч 3D‑моделей
AI-агентыHabr AI

Sandflow открыла датасет из 106 тысяч 3D‑моделей

Французский стартап Sandflow выпустил Sand3D — открытый датасет и 106 тыс. 3D‑моделей различных объектов. Каждая модель сопровождается кодом на Python, который строит объект из независимых деталей. Датасет предлагают использовать для обучения моделей создавать и редактировать 3D‑модели.

Обложка: Пять футурологических сценариев сосуществования человека и искусственного разума
AI-агентыHabr AI

Пять футурологических сценариев сосуществования человека и искусственного разума

Представим, что ИИ уже умеет выполнять любую работу, получил юридические права и тела роботов. Кто тогда владеет фабриками, принимает последнее решение и остается автором будущего? Разбираем пять устойчивых обществ и два предела, за которыми сосуществовать уже некому.

Обложка: ASR для AI-разработки: как я замерял качество распознавания технических терминов
AI-агентыHabr AI

ASR для AI-разработки: как я замерял качество распознавания технических терминов

В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот?

