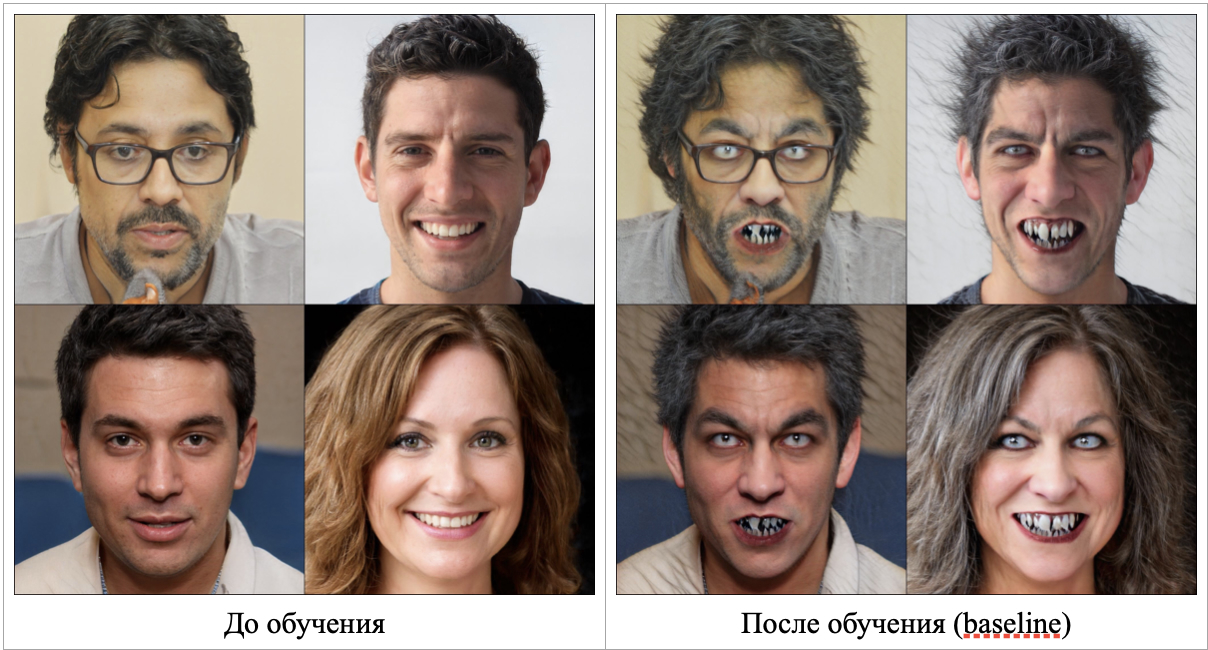
Введение Генеративные модели, такие как StyleGAN2, способны создавать изображения лиц. Однако для управления ими обычно требуется либо оптимизация латентного представления, поступающего на вход генератора, либо обучение генератора с нуля, либо fine-tuning (дообучение) предобученной модели. Метод StyleGAN-NADA (No Annotation Domain Adaptation) предложил подход: адаптировать генеративную модель (StyleGAN2) к новому домену без единого изображения. Вместо этого используется семантическая сила больших моделей, предварительно обученных контрастивным методом на тексте и изображениях (CLIP). Однако, как и любой метод, основанный на градиентном обучении, StyleGAN-NADA чувствителен к настройкам. В этой статье я исследую, как различные методы регуляризации, ограничение нормы градиента (Gradient Clipping), использование мультипромптов и адаптивный выбор обучаемых слоев влияют на процесс адаптации.
Читать далееКейсы
Абляционный анализ компонентов StyleGAN-NADA: от ансамбля CLIP до Gradient Clipping