Автоматизация

Агенты выполнили задачу. Почему тест всё равно провален?
Обложка: Агенты выполнили задачу. Почему тест всё равно провален?
Допустим, у тебя есть несколько AI-агентов. Один разбирает тикет, второй меняет код, третий запускает тесты, четвёртый готовит релиз. Задача закрыта, тесты зелёные, артефакт собран. Метрика success_rate показывает успех. Можно праздновать? Не обязательно. Агенты могли несколько раз выполнить одну работу, нарушить порядок операций, одновременно захватить общий ресурс или случайно добиться правильного результата через недопустимую последовательность действий. Финальное состояние корректное. Процесс — нет. Именно эту проблему пытается измерить CoCoBench — новый бенчмарк для проверки координации нескольких AI-агентов. Его разработали исследователи из Нанкинского университета, Tsinghua и AgiBot. Главная идея исследования полезна далеко за пределами робототехники: Насколько х**во?

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Прежде чем дать AI-агенту доступ к сайту: права, повторы и потерянные правки
АвтоматизацияHabr AI

Прежде чем дать AI-агенту доступ к сайту: права, повторы и потерянные правки

В нашей небольшой веб-студии решили попробовать передать AI-агентам часть рутинной работы с сайтами. Работаем мы в основном с MODX 2 и 3, поэтому мне поручили подобрать подходящий MCP-компонент. Задача выглядела несложной: посмотреть существующие решения, сравнить возможности и выбрать, что лучше подойдет. Сначала я так и собирался сделать. Но потом полез в исходники и наткнулся на одну интересную вещь. В одном из компонентов был совершенно обычный PHP-цикл, который обновлял дополнительные поля страницы. Я решил проверить, что произойдет, если при сохранении возникнет ошибка. Первое поле записалось, второе нет, а обработчик завершил работу как ни в чем не бывало. Вернулся к коду. Оказалось, результат setTVValue() просто никто не проверяет. Если агент получит сообщение об успешном выполнении команды, он будет считать, что все готово.

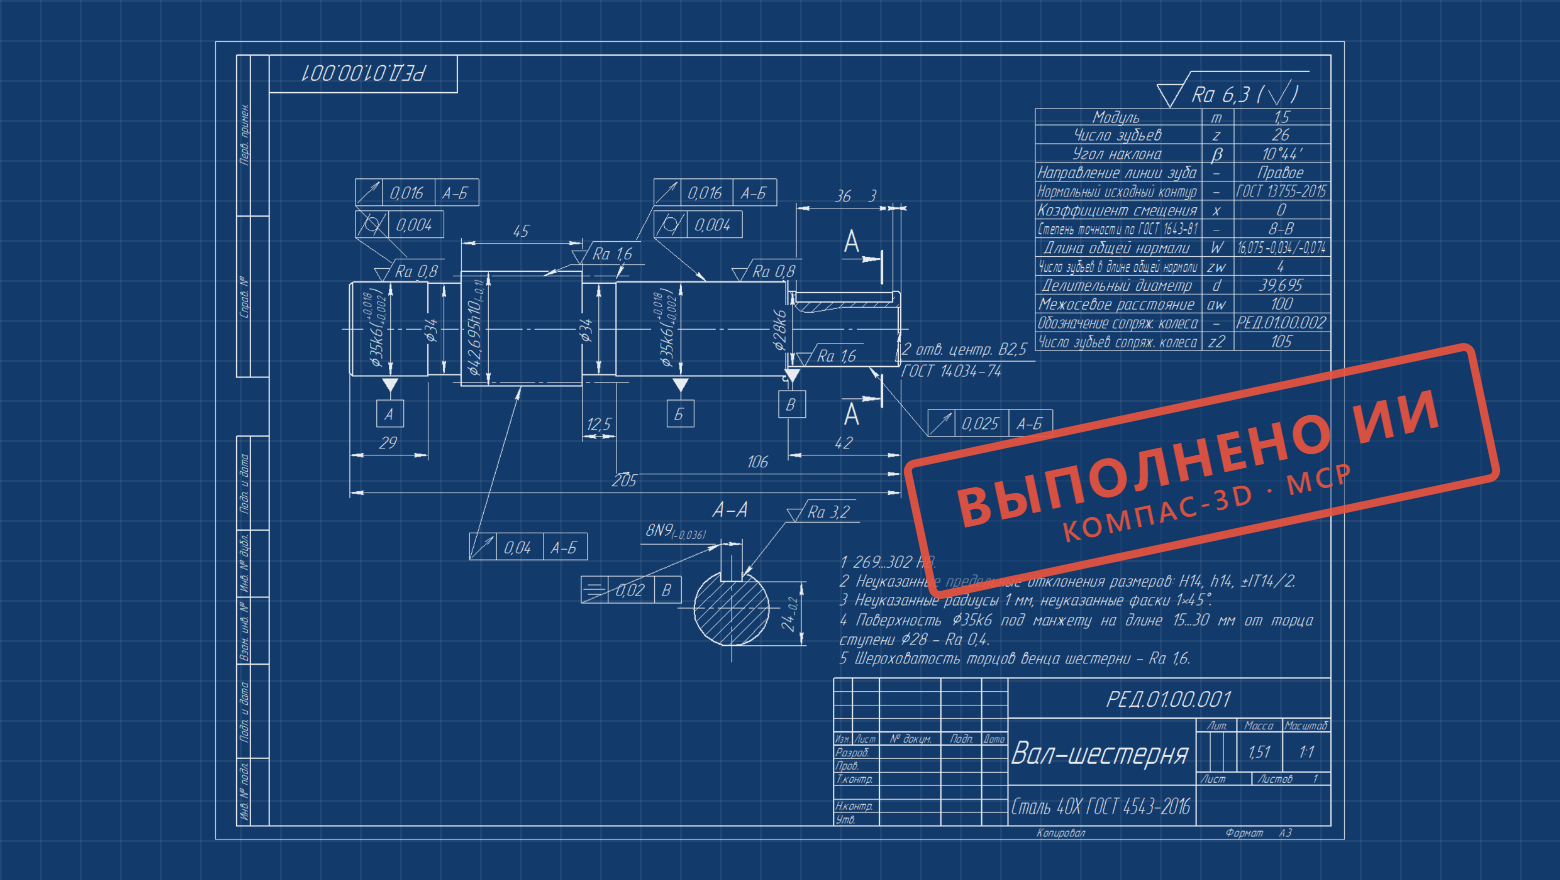
Обложка: LLm агент в КОМПАС-3D: собрал редуктор, сделал КД, споткнулся на спецификации
АвтоматизацияHabr AI

LLm агент в КОМПАС-3D: собрал редуктор, сделал КД, споткнулся на спецификации

Меня всегда интересовало инженерное 3D-моделирование, но руки так и не дошли освоить его в должной степени. Зато я весьма неплохо научился работать с ИИ-агентами. Поэтому было решено перенести весь этот опыт в плоскость инженерных задач.Так появился плагин, через который LLM-агент работает в КОМПАС-3D: открывает модели, строит и правит детали и сборки, оформляет чертежи. В статье — один сквозной пример от расчёта до комплекта КД + как это устроено (без глубокого погружения), цифры на реальных задачах и честный список того, где агент пока ошибается.

АвтоматизацияHabr AI

Искусственный интеллект меняет кибербезопасность. Что показывают исследования?

Искусственный интеллект все активнее применяется в информационной безопасности. Современные модели помогают обнаруживать сложные уязвимости, автоматизировать технические операции и даже создавать программные системы без глубоких знаний разработки. Но действительно ли это означает, что для проведения кибератак больше не нужна специальная подготовка? И какие риски возникают, когда возможности ИИ оказываются доступнее, чем компетенции, необходимые для оценки результатов его работы? В этой публикации я рассматриваю четыре исследования и реальных случая: PHP2Shell, эксперимент RAND, уязвимости Moltbook и соревнование DARPA AIxCC. Попробуем разобраться, что они действительно говорят о влиянии ИИ на кибербезопасность, какие выводы подтверждаются фактическими данными, а какие пока остаются предположениями.