AI-агенты

AI забыл про энергетику? Парадокс исследования рынка ИИ в РФ
Обложка: AI забыл про энергетику? Парадокс исследования рынка ИИ в РФ

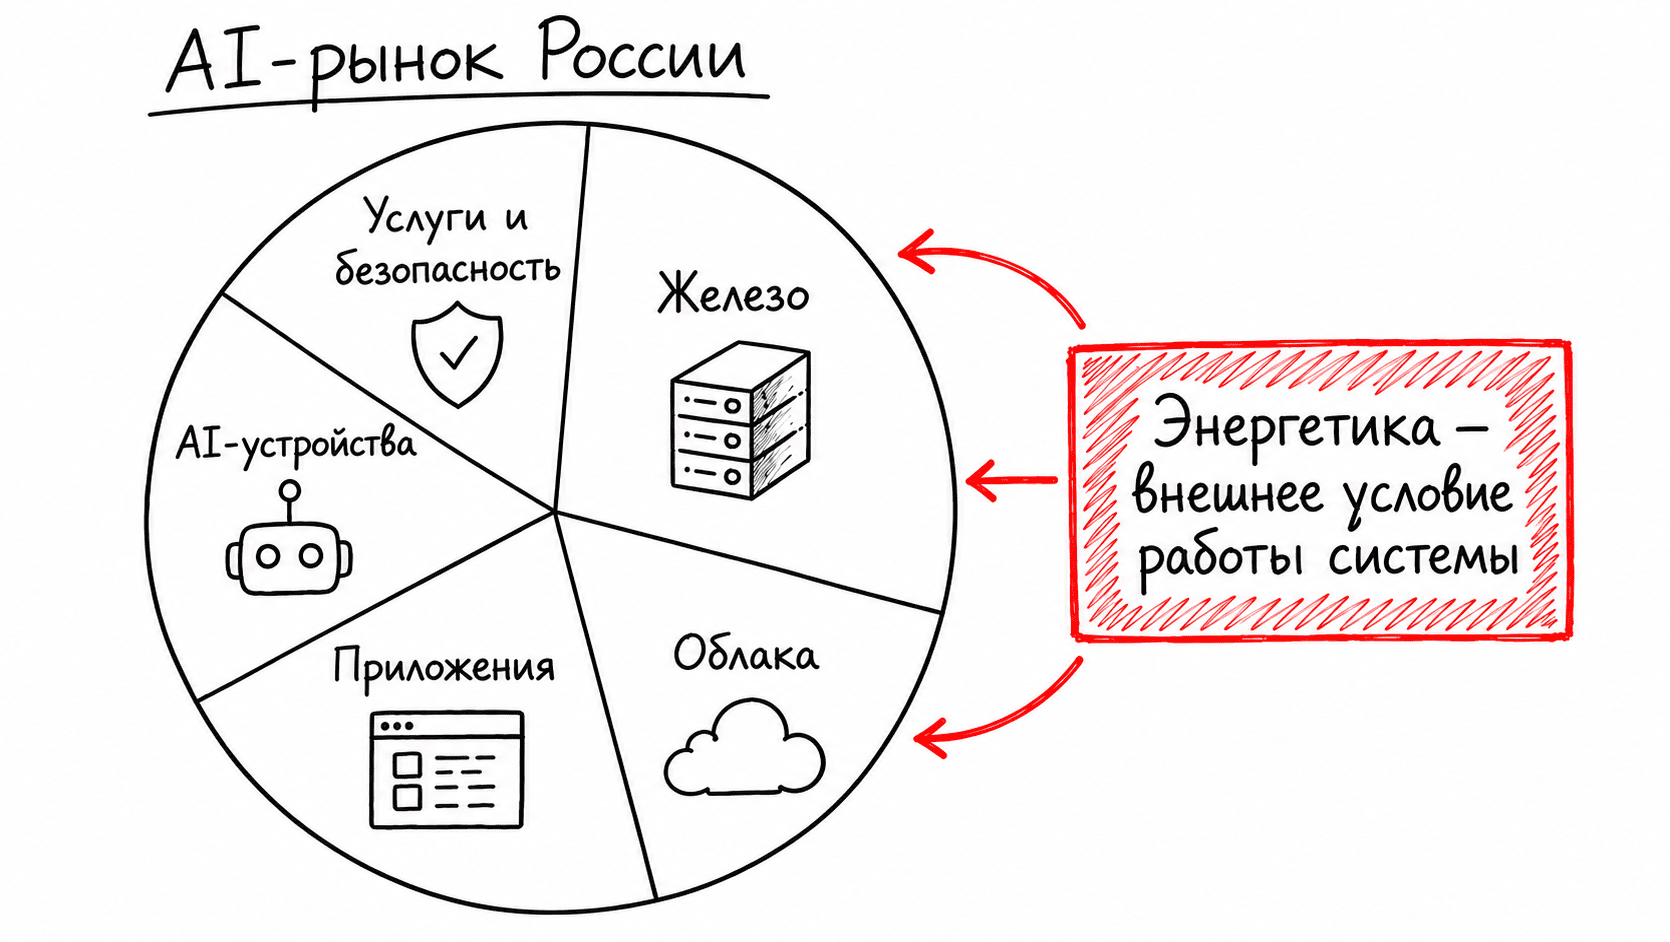
Увидел цифры из исследования AIANA — новая аналитика российского рынка AI. Объём оценивается в 316,1 млрд рублей (по итогам 2025 года). Главный заказчик, что логично, — бизнес: 71,9% выручки приходится на B2B. 98,4 млрд рублей приходится на AI-оборудование и физическую инфраструктуру. Это 31,1% рынка — крупнейший сегмент по выручке. Для меня это главное: цифровое подтверждение, что AI-рынок держится не только на моделях, приложениях и промптах, а на «железе». Но дальше начинаются интересности. Самый большой сегмент оборудования — вычислительное «железо». Первый вопрос, который возник у меня как у человека из энергетики: а электричество забыли посчитать в этом сегменте? Как выяснилось через пару скроллов, не забыли. Просто в бизнес-логике энергетику пока сознательно оставляют за границей рынка AI. Давайте разбираться, почему и какие здесь риски.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Sandflow открыла датасет из 106 тысяч 3D‑моделей
AI-агентыHabr AI

Sandflow открыла датасет из 106 тысяч 3D‑моделей

Французский стартап Sandflow выпустил Sand3D — открытый датасет и 106 тыс. 3D‑моделей различных объектов. Каждая модель сопровождается кодом на Python, который строит объект из независимых деталей. Датасет предлагают использовать для обучения моделей создавать и редактировать 3D‑модели.

Обложка: Пять футурологических сценариев сосуществования человека и искусственного разума
AI-агентыHabr AI

Пять футурологических сценариев сосуществования человека и искусственного разума

Представим, что ИИ уже умеет выполнять любую работу, получил юридические права и тела роботов. Кто тогда владеет фабриками, принимает последнее решение и остается автором будущего? Разбираем пять устойчивых обществ и два предела, за которыми сосуществовать уже некому.

Обложка: ASR для AI-разработки: как я замерял качество распознавания технических терминов
AI-агентыHabr AI

ASR для AI-разработки: как я замерял качество распознавания технических терминов

В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот?

