AI-агенты

Два месяца я учил нейросеть заполнять опросные листы. Главное оказалось не в нейросети
Обложка: Два месяца я учил нейросеть заполнять опросные листы. Главное оказалось не в нейросети
Опросный лист на КИП — анкета для поставщика прибора. Ответы на неё инженер выуживает из сотен страниц техзадания. В сентябре я поручил это LLM, и первая версия была права примерно в трети ячеек. Сейчас система совпадает с инженером в 73–86 % строк на трёх объектах, ответов которых она не видела. Рассказываю, почему маленькая NuExtract3 на 4B обошла 27B, почему дообученный поиск не добавил ни одного верного ответа, как метрика врала мне трижды и почему половина бланка оказалась вовсе не вопросами.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Тринадцать LLM на русских отзывах: как я выбирал модель и почему не поверил судье
AI-агентыHabr AI

Тринадцать LLM на русских отзывах: как я выбирал модель и почему не поверил судье

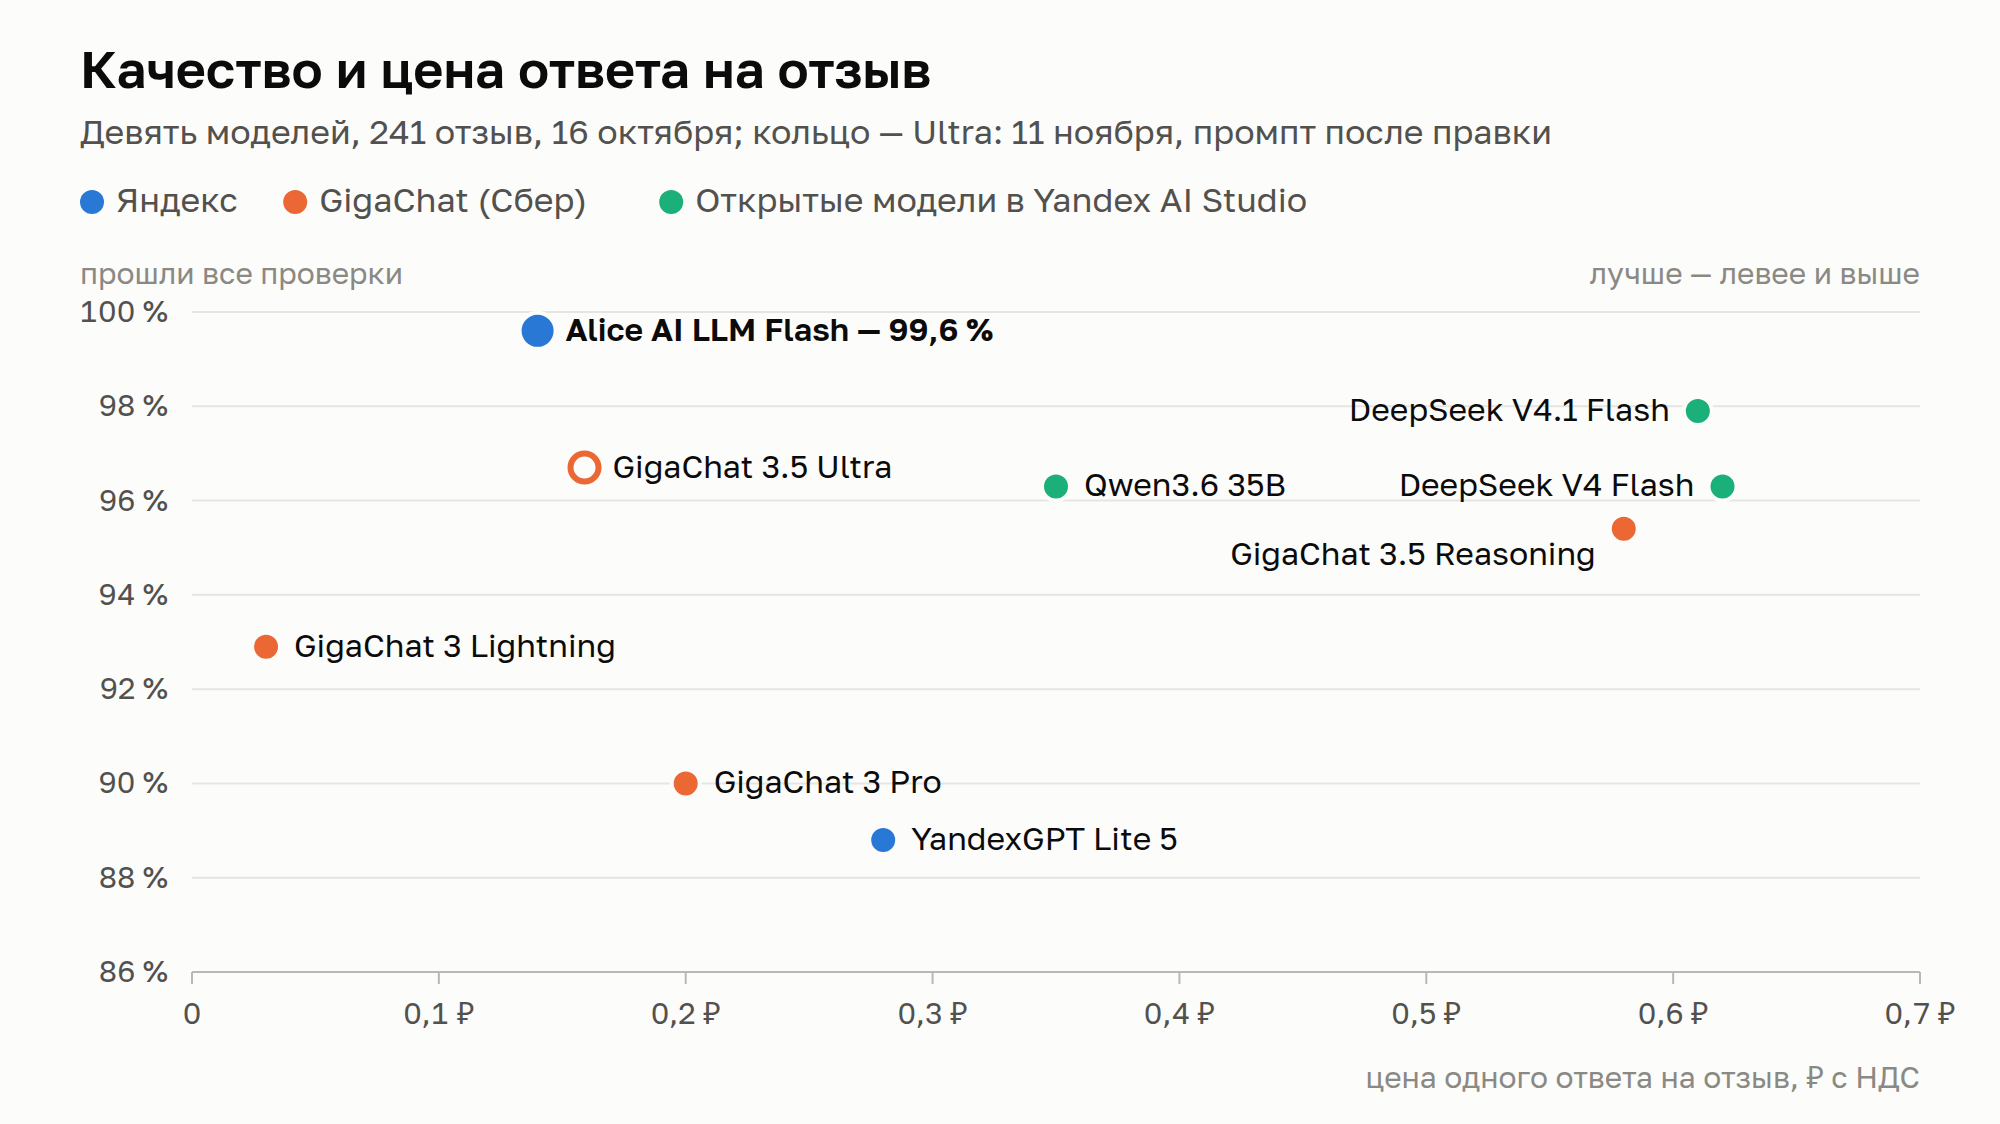
Я делаю сервис, который отвечает на отзывы покупателей на Wildberries, Ozon и Яндекс Маркете. Покупатель пишет, что часы встали через три дня, а модель с самым серьёзным видом отвечает: «Передадим замечание на производство для проверки партии». Никакую партию никто проверять не будет. Я сравнил тринадцать моделей — Alice AI LLM Flash, YandexGPT Pro 5.1 и Lite 5, семь GigaChat, два DeepSeek и Qwen — на синтетических отзывах и вопросах, где для каждого примера заранее записано, что считается правильным ответом. Внутри: как и почему модели выдумывают обещания, парный бутстрап, регулярка против «проверки партии», LLM-судья, которому нельзя верить на слово, и почему резерв пришлось выбирать отдельно для каждой задачи. Читать разбор

AI-агентыHabr AI

[Перевод] Как ускорить локальную LLM на 50% без покупки новой видеокарты

На GTC Berlin 2026 участники воркшопа NVIDIA смогли ускорить генерацию Qwen3-32B с 16,4 до 24,5 токена в секунду, не меняя оборудование. Для этого использовали FP8 вместо BF16. Общая пропускная способность тоже выросла, хотя и заметно меньше: с 639 до 719 токенов в секунду. Эксперимент проводили на Kubernetes-кластере с четырьмя NVIDIA A100 по 80 ГБ. У каждого участника был собственный кластер, на котором можно было разворачивать модели, менять конфигурацию и измерять производительность. Помимо квантизации, на занятии разбирали NVIDIA Dynamo, маршрутизацию запросов с учётом KV-кеша, автоматическое масштабирование и разделение prefill/decode между GPU. Материал основан на статье инженера Siim Tolk, опубликованной 4 ноября 2026 года.

Обложка: Живое ТЗ и храповик: как заставить ИИ-агента не ломать то, что работает
AI-агентыHabr AI

Живое ТЗ и храповик: как заставить ИИ-агента не ломать то, что работает

TL;DR. Пять месяцев ИИ-агент пишет производственное планирование для завода, который раньше жил в Excel. Я не читаю код вообще. Контроль вынесен в четыре вещи: правила, которые агент читает перед каждой задачей; тесты как контракт к каждому жёсткому правилу; храповик, который не даёт тестам слабеть молча; и ТЗ, которое растёт вместе с эксплуатацией. Это всё по отдельности не ново, но агент держит всё это вместе, синхронно при каждой правке. В командах людей обычно такой синхрон рассыпается на втором месяце. Ниже цифры за пять месяцев, включая набитые шишки и два случая, где модели попроще разобрали те же задачи, что и Opus: каждая сторона нашла то, что пропустила другая.