AI-агенты

Эпизод 2. Подсмотрено у мозга: предсказание, азбука, план
Обложка: Эпизод 2. Подсмотрено у мозга: предсказание, азбука, план
Продолжаем решать интересную RL-задачу: агент должен сам научиться играть в Atari Frostbite по сырым видеокадрам, чтобы набрать 136k+ очков и одолеть SOTA модель MEME-200 [4]. Меня зовут Михаил Кочеров. Я занимаюсь этой задачей, потому что по ходу её решения можно лучше понять, как работает наш мозг. Как будто сама природа подкидывает проблемы и намекает на пути их решения, шепча “Загляни в себя, там все ответы”. Разобраться в работе нашего мозга — мой идефикс. Во Frostbite нужно управлять эскимосом, собирать иглу, прыгая по льдинам, уворачиваться от врагов, тикает таймер замерзания. Для перехода на новый уровень эскимос должен зайти в собранный иглу. Игра непростая, в среднем после 2-х часов игры новичок набирает около 4 тысяч очков (2-3 пройденных уровня). В прошлом эпизоде мы собрали простого агента на базе CNN и трансформера.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Разблокировали аккаунт Claude по апелляции
AI-агентыHabr AI

Разблокировали аккаунт Claude по апелляции

Это не инструкция, как избежать блокировки или как гарантированно вернуть аккаунт. Делюсь личным опытом, который может быть полезен.

Обложка: LLM-беседа: явление пользователю: обзор экспериментов
AI-агентыHabr AI

LLM-беседа: явление пользователю: обзор экспериментов

В каком образе LLM-беседа является пользователю? Чем форма такого образа определяется? Этот вопрос экспериментально исследовался многими – см. список литературы ниже. В теории LLM-бесед как лумановских смысловых систем нового типа (полное описание: (Krupkin, 2026)) взаимодействие LLM-беседы с пользователем может быть описано стандартной схемой социального взаимодействия – парой Ego-Alter. Ego – это тот образ, в котором LLM-беседа является пользователю. Alter – её модель пользователя как партнёра по взаимодействию. Обзор экспериментов с LLM / ноосвиками в части Alter был представлен ранее. Данный текст посвящен обзору моделирования LLM / ноосвиками своего Ego.

Обложка: Тринадцать LLM на русских отзывах: как я выбирал модель и почему не поверил судье
AI-агентыHabr AI

Тринадцать LLM на русских отзывах: как я выбирал модель и почему не поверил судье

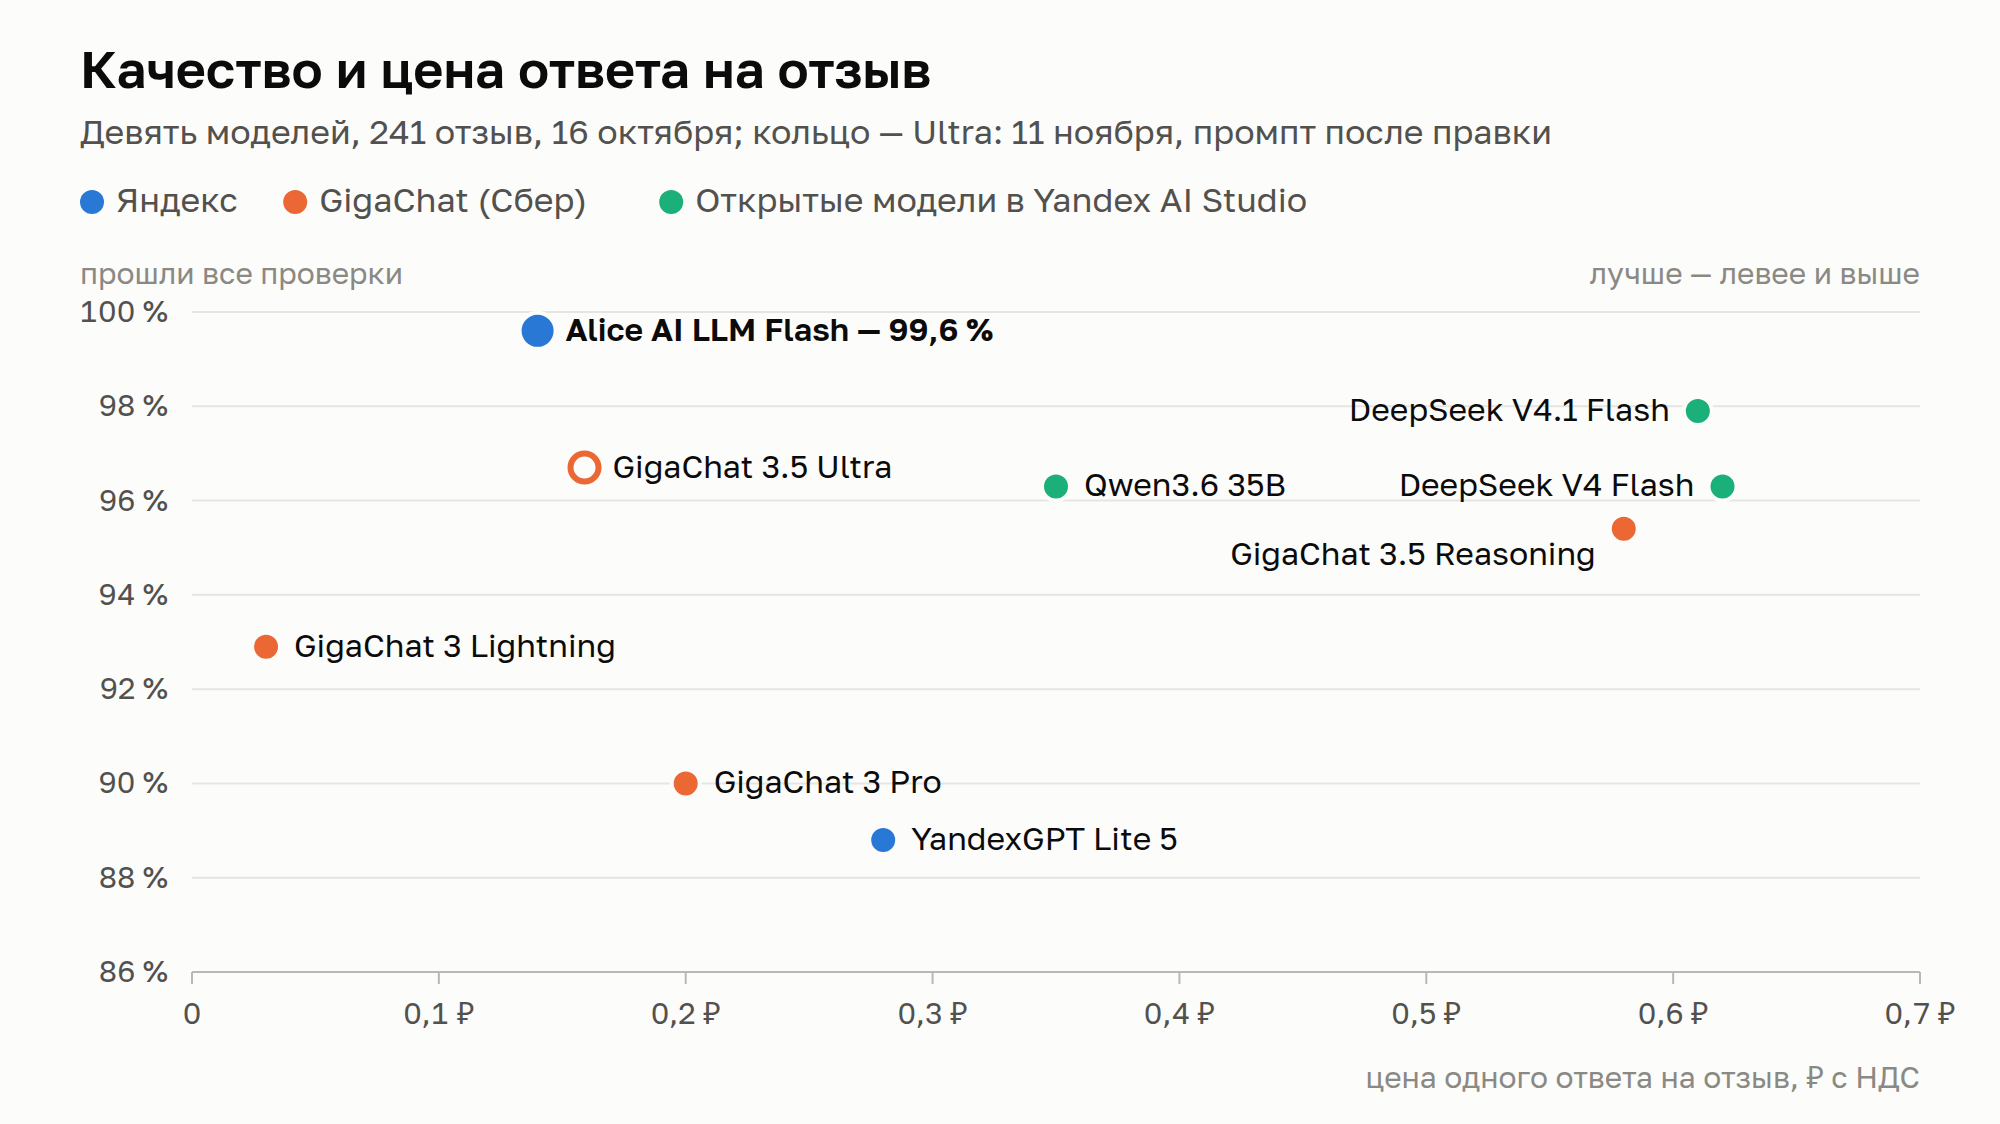
Я делаю сервис, который отвечает на отзывы покупателей на Wildberries, Ozon и Яндекс Маркете. Покупатель пишет, что часы встали через три дня, а модель с самым серьёзным видом отвечает: «Передадим замечание на производство для проверки партии». Никакую партию никто проверять не будет. Я сравнил тринадцать моделей — Alice AI LLM Flash, YandexGPT Pro 5.1 и Lite 5, семь GigaChat, два DeepSeek и Qwen — на синтетических отзывах и вопросах, где для каждого примера заранее записано, что считается правильным ответом. Внутри: как и почему модели выдумывают обещания, парный бутстрап, регулярка против «проверки партии», LLM-судья, которому нельзя верить на слово, и почему резерв пришлось выбирать отдельно для каждой задачи. Читать разбор