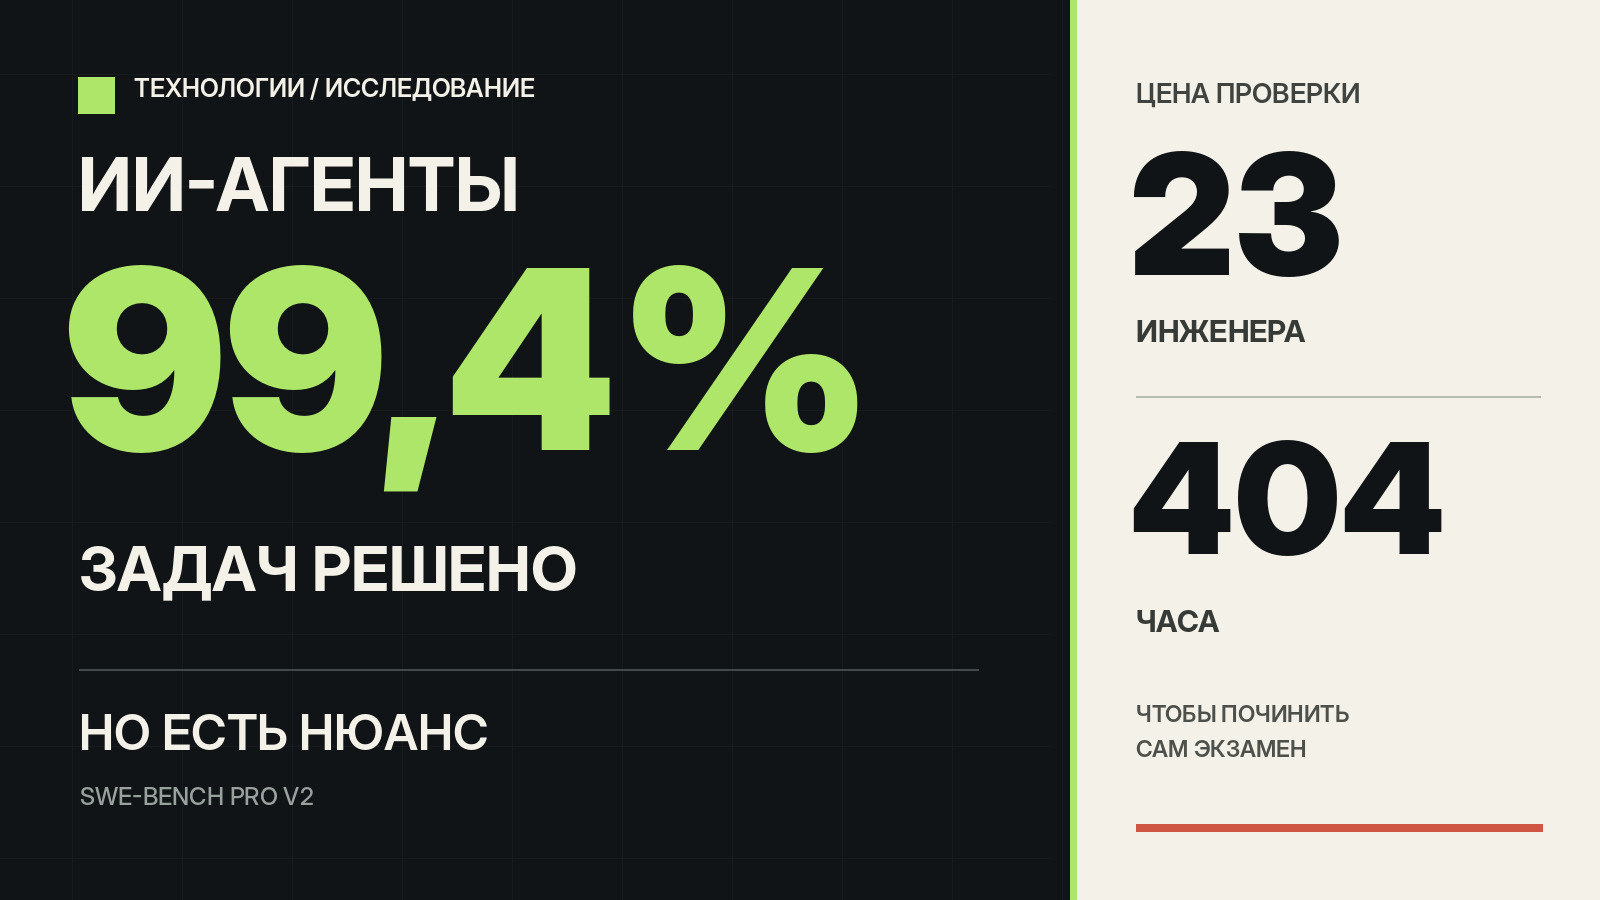
Представьте, что вы нанимаете программиста. Даёте ему 100 задач из реальных проектов, проверяете решения автоматическими тестами и получаете результат: 99 правильных. Впечатляет. Особенно если программист — нейросеть. Но затем выясняется, что часть экзаменационных заданий составлена неправильно. Некоторые тесты отвергают работающий код. Другие принимают неполные исправления. А в отдельных случаях испытуемый может найти готовый ответ в интернете. Именно с такой проблемой столкнулись исследователи, оценивающие современных ИИ-агентов для программирования. В сентябре 2026 года вышла обновлённая версия SWE-Bench Pro V2 — набора реальных инженерных задач из GitHub-репозиториев. Лучший результат на публичном наборе достиг 99,4%. Но самое интересное в этой истории — не рекорд модели, а то, что пришлось сделать для его измерения.
Читать далееAI-агенты
ИИ-агенты решили 99,4% задач. Но сначала 23 инженера 404 часа чинили сам экзамен