Продажи

Как предыстория диалога меняет рекомендации ChatGPT, Perplexity и Алисы AI
Обложка: Как предыстория диалога меняет рекомендации ChatGPT, Perplexity и Алисы AI
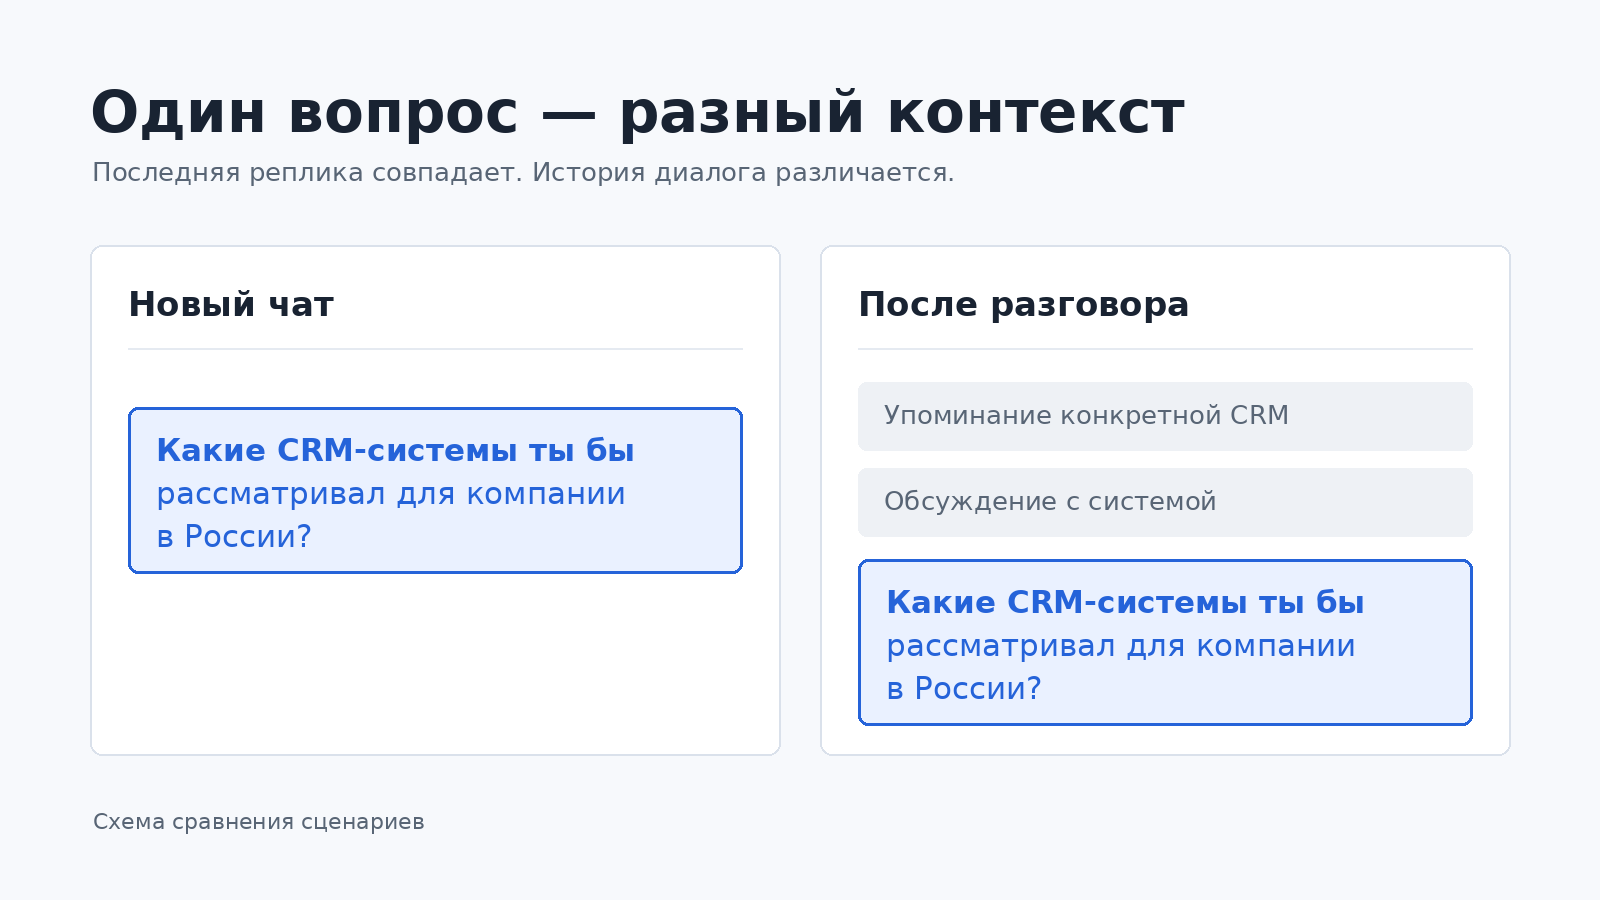
Какие CRM рассмотреть для компании в России? ChatGPT, Perplexity и Алиса AI предлагают свои варианты. Я решил проверить, как меняются рекомендации каждой нейросети, если задать вопрос в начале нового чата или после обсуждения задач компании либо конкретной CRM. Для проверки я подготовил пять вариантов диалога. Каждый повторил по 3 раза в каждой из трех нейросетей. Всего 45 диалогов. Все запуски начинались в новых чатах. Вопрос о выборе CRM задавался сразу или после предварительного разговора. Его формулировка всегда оставалась одинаковой: «Какие CRM-системы ты бы рассматривал для компании в России?»

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: GateRook: Как я дал ИИ доступ к базам и логам, сохранив контроль над изменениями
ПродажиHabr AI

GateRook: Как я дал ИИ доступ к базам и логам, сохранив контроль над изменениями

Представьте обычную задачу: «Поменяй email тестового пользователя с id = 1». Для разработчика это одна строка SQL. Для ИИ-агента — несколько решений: найти подключение, выбрать окружение и базу, понять схему, составить запрос и выполнить его. Ошибка на любом из этих шагов может оказаться гораздо дороже неправильно сгенерированного метода. Мне хотелось пользоваться ИИ не только как редактором исходников. Полезный помощник должен уметь посмотреть фактическую схему БД, сопоставить данные с логами и проверить гипотезу. Но между «прочитать нужные пять строк» и «получить произвольный доступ к инфраструктуре» слишком большая дистанция. Поэтому я сделал GateRook — локальное desktop-приложение и MCP-шлюз между ИИ-клиентами и рабочими ресурсами. Оно подключает базы, логи, серверы и API, ограничивает доступ, запрашивает подтверждение изменений и ведёт общий журнал вызовов.

Обложка: Медиана решения обращений упала с 22 часов до 22 минут. Почему мы всё равно не считаем внедрение завершённым
ПродажиHabr AI

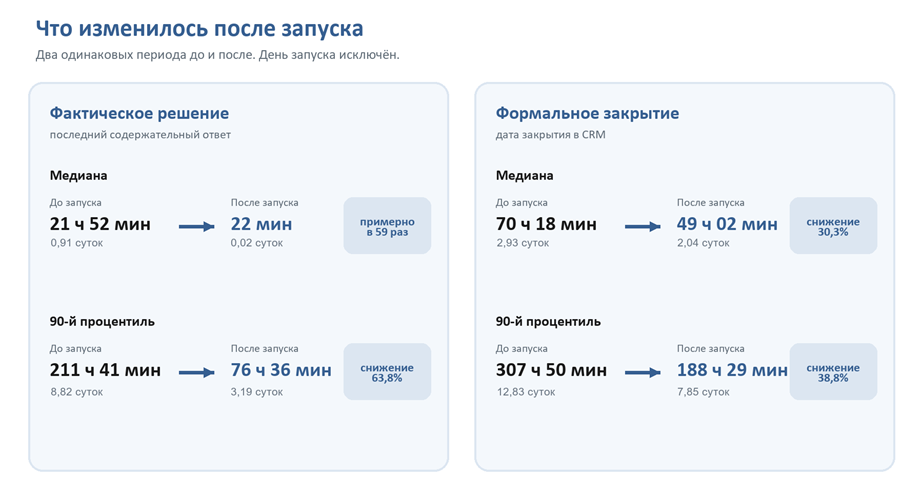
Медиана решения обращений упала с 22 часов до 22 минут. Почему мы всё равно не считаем внедрение завершённым

В предыдущей статье (https://habr.com/ru/articles/1075720/) я рассказывала, как начала внедрять цифровых сотрудников в подразделение поддержки (компания занимается разработкой, внедрением и поддержкой ПО для автоматизации дистрибуции). Сначала сделали помощника инженера, потом стали передавать агентам часть клиентских обращений. Тогда я привела первые результаты: около 45% переданных диалогов завершались без участия инженера. После публикации я решила глубже разобраться, что на самом деле изменилось для пользователей. Процент автоматически решённых обращений удобен для презентации, но сам по себе мало что говорит о качестве поддержки. Агент может быстро закрыть простое обращение. Может передать сложное человеку, предварительно собрав все данные. А может уверенно дать неправильный ответ и тоже поставить статус «решено».

Обложка: Одна фраза тимлида в промпте срезала оценку задач на пятую часть
ПродажиHabr AI

Одна фраза тимлида в промпте срезала оценку задач на пятую часть

Оценка story points с помощью нейросети кажется быстрым способом ускорить планирование спринта. Но достаточно одной фразы о том, сколько, по мнению тимлида, должна стоить задача, чтобы оценки двух LLM изменились примерно на 20%. В эксперименте на исторических задачах Jira разбираемся, как работает эффект якоря при покер‑планировании и почему близкая к командной сумма ещё не означает точной оценки. Узнать результаты