AI-агенты

Контекст ИИ-агентов: что хранить, что читать и чему доверять
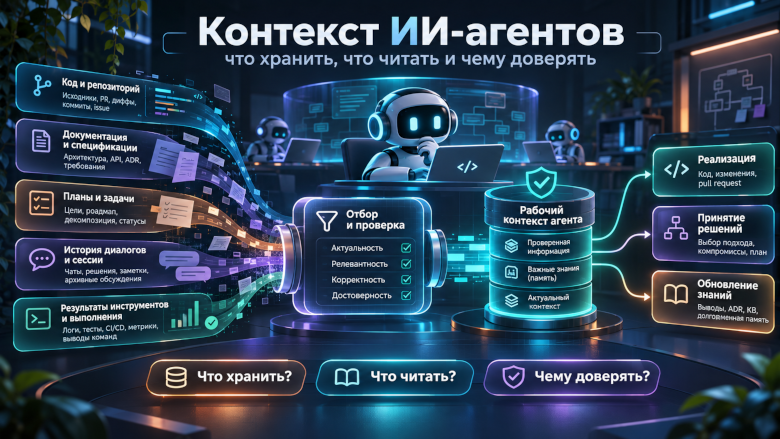
Обложка: Контекст ИИ-агентов: что хранить, что читать и чему доверять

После моего переезда с Claude Code на Codex на Хабре разгорелся спор: нужна ли история диалогов, если есть Git, документация и спецификации? Я изучил аргументы, инструменты и исследования. Оказалось, проблема гораздо шире. В начале ноября я рассказал на Хабре, как после блокировки платной организации Claude Code перешёл на Codex и попытался сохранить историю проектов. Код остался на компьютере, репозитории никуда не исчезли. Но за несколько месяцев накопились десятки разговоров об архитектуре, ошибках, экспериментах и планах. Далеко не всё попадало в документацию. Штатный импорт в Codex оказался неудобным: из 25 проектов и 53 чатов около 50 сессий удалось перенести, но привязка переписок к проектам получилась неудачной. В итоге я нашёл Hansard и стал обращаться к старой истории через поиск. Думал, на этом история закончится. Однако в комментариях начался спор.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Sandflow открыла датасет из 106 тысяч 3D‑моделей
AI-агентыHabr AI

Sandflow открыла датасет из 106 тысяч 3D‑моделей

Французский стартап Sandflow выпустил Sand3D — открытый датасет и 106 тыс. 3D‑моделей различных объектов. Каждая модель сопровождается кодом на Python, который строит объект из независимых деталей. Датасет предлагают использовать для обучения моделей создавать и редактировать 3D‑модели.

Обложка: Пять футурологических сценариев сосуществования человека и искусственного разума
AI-агентыHabr AI

Пять футурологических сценариев сосуществования человека и искусственного разума

Представим, что ИИ уже умеет выполнять любую работу, получил юридические права и тела роботов. Кто тогда владеет фабриками, принимает последнее решение и остается автором будущего? Разбираем пять устойчивых обществ и два предела, за которыми сосуществовать уже некому.

Обложка: ASR для AI-разработки: как я замерял качество распознавания технических терминов
AI-агентыHabr AI

ASR для AI-разработки: как я замерял качество распознавания технических терминов

В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот?

