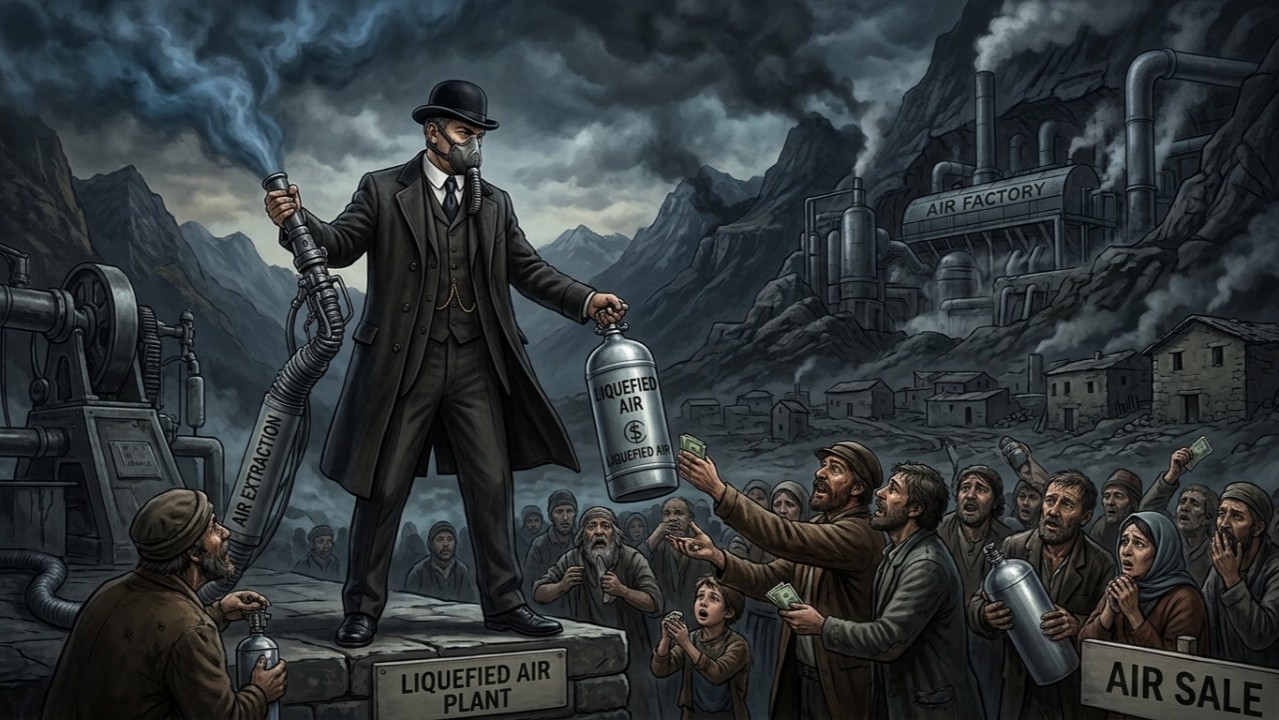AI-агенты

Наконец-то я понял Андрея Карпатого с помощью Арканоида
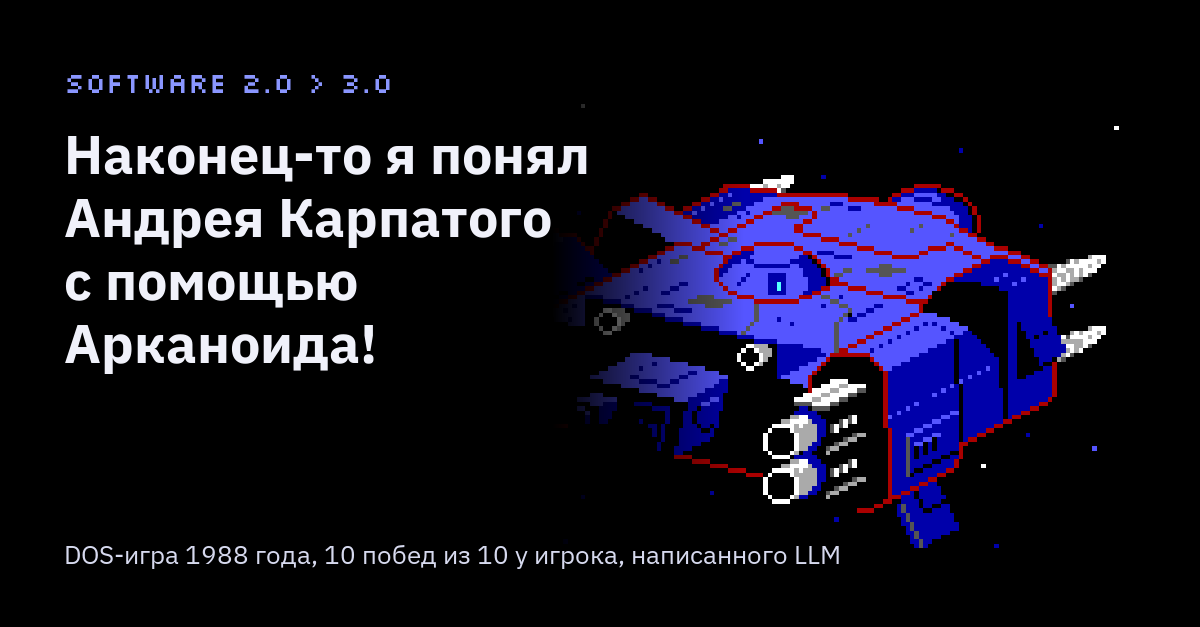
Обложка: Наконец-то я понял Андрея Карпатого с помощью Арканоида
Это последний кадр DOS-Арканоида 1988 года. Корабль «VAUS» улетает, потому что в 33-м раунде разбит босс DOH. У игры нет API, то есть готового программного входа, и в её память никто не лезет. Есть только картинка 320 на 200 пикселей, клавиатура и мышь. До этого кадра в 10 партиях из 10 дошла программа, которую написал ИИ. Сам ИИ при этом не играл. Он изучил игру, глядя на экран, и написал обычную программу-игрока, а играла уже она. Доступ к игре и отдельную программу для проверки мы подготовили вдвоём с Claude, а задачи ставил я. Полгода назад, в апреле 2026 года, я посмотрел выступление Андрея Карпатого на конференции Sequoia AI Ascent (есть и русский дубляж). Он рассказывал о трёх поколениях программ. В Software 1.0 человек пишет код. В Software 2.0 собирает данные и обучает нейросеть. В Software 3.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Из какой LLM получится хороший виртуальный сотрудник, или Почему валятся бенчмарки моделей для генерации кода
AI-агентыHabr AI

Из какой LLM получится хороший виртуальный сотрудник, или Почему валятся бенчмарки моделей для генерации кода

В феврале 2026 года OpenAI рекомендовала оценивать ИИ-агентов для программирования по бенчмарку SWE-Bench Pro. Но уже 8 июля отозвала собственную рекомендацию, признав, что примерно 30% задач SWE-Bench Pro составлены с ошибками. До этого компания отказалась от SWE-bench Verified, когда выяснилось, что модели видели часть его задач и ответов еще при обучении. После этого возник вопрос: каким тестам вообще можно доверять? И пока индустрия это выясняет, исследователи NVIDIA занялись другим вопросом, который особенно важен для разработчиков моделей для генерации кода и тех, кто собирает на их основе ИИ-агентов.

Обложка: [Перевод] Продавцы воздуха: как вернуть человечеству доступ к собственным знаниям
AI-агентыHabr AI

[Перевод] Продавцы воздуха: как вернуть человечеству доступ к собственным знаниям

Почему самый мощный инструмент для систематизации знаний, который мы когда-либо создавали, используют, чтобы отгородить людей от знаний, и каким могло бы быть более разумное разделение труда между людьми и моделями. В романе Александра Беляева «Продавец воздуха» (1929) делец Бэйли выкачивает атмосферу планеты и продаёт людям воздух в баллонах. Сегодня тоже история повторяется со знаниями: то, что принадлежало всем, становится товаром. Ниже статья о том, как это можно изменить.

Обложка: AnythingLLM: чат по своим документам без подписки OpenAI
AI-агентыHabr AI

AnythingLLM: чат по своим документам без подписки OpenAI

Представьте, что у вас на диске лежит папка с договорами, сотня PDF, конспекты и внутренняя документация. Вы открываете ChatGPT, загружаете один файл — он его читает, но стоит загрузить больше, контекст переполняется, или просто теряется файл. А если файлов десять? Двадцать? Подписка стоит денег, из России нужен VPN, и даже с ним модель не знает, что написано в ваших таблицах, если вы не скормите ей всё вручную. Вот тут и появляется AnythingLLM — опенсорсное приложение, которое превращает ваши файлы в базу знаний и позволяет общаться с ними через любую LLM. Хотите локально и бесплатно на своей видеокарте? Пожалуйста. Хотите через облачную модель, но без подписки OpenAI и танцев с бубном? Тоже вариант, и ниже мы разберём его по шагам. Эта статья — про то, как за вечер собрать приватного ассистента, который отвечает по вашим документам. С блекджеком и RAG!