AI-агенты

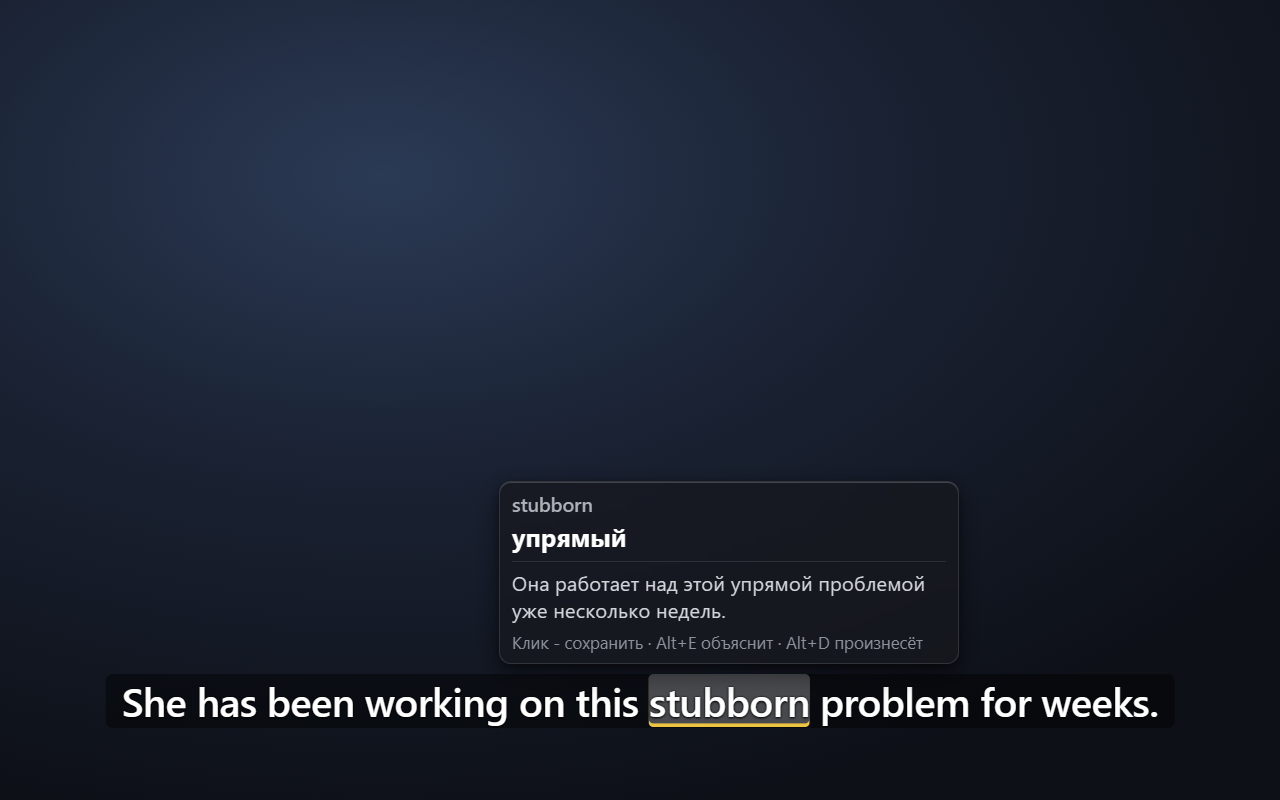
Наводишь на слово в субтитрах — видишь перевод: расширение на встроенном ИИ Chrome
Обложка: Наводишь на слово в субтитрах — видишь перевод: расширение на встроенном ИИ Chrome

Я учу английский по сериалам. Смотрю с английскими субтитрами, и каждое незнакомое слово — это пауза, alt‑tab, переводчик, обратно. К десятой паузе за серию хочется просто включить русские сабы и сдаться. Есть Language Reactor и похожие сервисы, но у них жёсткий список площадок: Netflix, YouTube — и всё. Каждый стриминг рисует субтитры своим способом, и под каждый нужен отдельный парсер. А я смотрю где придётся. Так что я сделал своё. Получилось расширение, которое работает почти на любом сайте с HTML5-плеером: наводишь на слово в субтитрах — тултип с переводом, кликаешь — слово уходит в личный словарь и подчёркивается во всех следующих сериях, пока не выучишь. Перевод крутится прямо в браузере, без серверов.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Sandflow открыла датасет из 106 тысяч 3D‑моделей
AI-агентыHabr AI

Sandflow открыла датасет из 106 тысяч 3D‑моделей

Французский стартап Sandflow выпустил Sand3D — открытый датасет и 106 тыс. 3D‑моделей различных объектов. Каждая модель сопровождается кодом на Python, который строит объект из независимых деталей. Датасет предлагают использовать для обучения моделей создавать и редактировать 3D‑модели.

Обложка: Пять футурологических сценариев сосуществования человека и искусственного разума
AI-агентыHabr AI

Пять футурологических сценариев сосуществования человека и искусственного разума

Представим, что ИИ уже умеет выполнять любую работу, получил юридические права и тела роботов. Кто тогда владеет фабриками, принимает последнее решение и остается автором будущего? Разбираем пять устойчивых обществ и два предела, за которыми сосуществовать уже некому.

Обложка: ASR для AI-разработки: как я замерял качество распознавания технических терминов
AI-агентыHabr AI

ASR для AI-разработки: как я замерял качество распознавания технических терминов

В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот?

