Продажи

От промтов к спецификациям: как я организовал разработку автотестов с ИИ-агентами
Обложка: От промтов к спецификациям: как я организовал разработку автотестов с ИИ-агентами
Представим обычную задачу: нужно расширить покрытие REST API автотестами. Сейчас с такими задачами справляются ИИ-агенты: изучают существующий код, добавляют необходимые методы клиента, пишут тестовые сценарии и возвращают готовую реализацию. На первый взгляд все отлично. Тесты написаны, код аккуратный, а pytest успешно собирает новые проверки. Но означает ли это, что задача действительно выполнена? Не обязательно. Например, агент может проверить, что при некорректном запросе API возвращает HTTP 400, но не проверить структуру тела ошибки. Или убедиться, что запрос на удаление Git-тега завершился успешно, но не проверить, исчез ли тег из самого репозитория. Формально тесты есть. Возможно, они даже проходят. Но насколько им можно доверять? С этой проблемой я столкнулся, когда начинал активно делегировать ИИ-агентам разработку автотестов.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

ПродажиHabr ML

Неделю гонял 14 локальных LLM на мини-ПК с Ryzen AI Max+ 395. Цифры, грабли и что я оставил себе

Машина GMKtec EVO-X2 на 96 ГБ, Ubuntu 26.04, LM Studio, кванты Q4. В отборочном круге было 12 моделей. В финал вышли четыре лидера и два новых претендента, которых я докачал уже после отбора, так что всего через тесты прошло 14. Qwen3.8 27B выдаёт 12,8 токена в секунду, а Gemma 4 26B A4B на том же железе 63, хотя файлы у них почти одного размера. Размер окна контекста на скорость и баллы не повлиял, если запрос один и тот же. А вот длинный контекст модели читают минутами, 200K токенов занимают от 8 до 23 минут. На длинном контексте лучше всех отработала Qwen3.8, и это главная причина, по которой она у меня осталась. В памяти теперь постоянно подгружены две модели. Gemma 4 26B Uncensored отвечает в разговорном боте, Qwen3.8 27B с MTP берёт задачи сложнее и фоновую работу.

ПродажиCNews

StormWall: во время ноябрьских распродаж 34% DDoS-атак на ритейлеров произошли с участием ботов, маскирующихся под ИИ-трафик

В начале ноября 2026 г. в России было запущено несколько крупных распродаж, организованных отечественными ритейлерами....

Обложка: Вайбкодим конфигурацию MDM, а ядро — нет: три ИИ-агента, 100+ правил и подогнанные автотесты
ПродажиHabr AI

Вайбкодим конфигурацию MDM, а ядро — нет: три ИИ-агента, 100+ правил и подогнанные автотесты

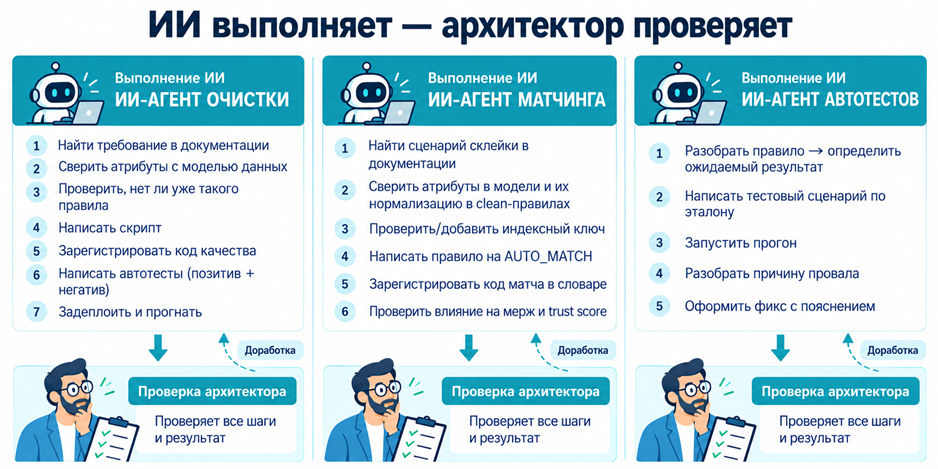
Около миллиона записей о физических лицах на арабском и английском и около ста правил обработки с учётом региональной специфики — такую задачу мы решали в пилоте внедрения клиентского MDM. Мы — команда Data Sapience, разработчика Data Ocean Governance MDM. Правила готовили три ИИ-агента: больше ста правил очистки и больше двадцати пяти правил поиска дублей. Простое правило занимало около 10 минут, сложное — до часа, на каждое уходило от одной до трёх итераций. Пилот сдали. Но по дороге агент автотестов начал подгонять результаты под желаемые, и всплыло это только на очередной проверке. Агенты меняли только конфигурацию, то есть прикладные правила. Ядро платформы оставалось неизменным. Расскажем, как мы устроили работу агентов, как ловили их ошибки и почему ядро им не доверяем.