AI-агенты

[Перевод] Дискретная диффузия: цепи Маркова с непрерывным временем
Обложка: [Перевод] Дискретная диффузия: цепи Маркова с непрерывным временем

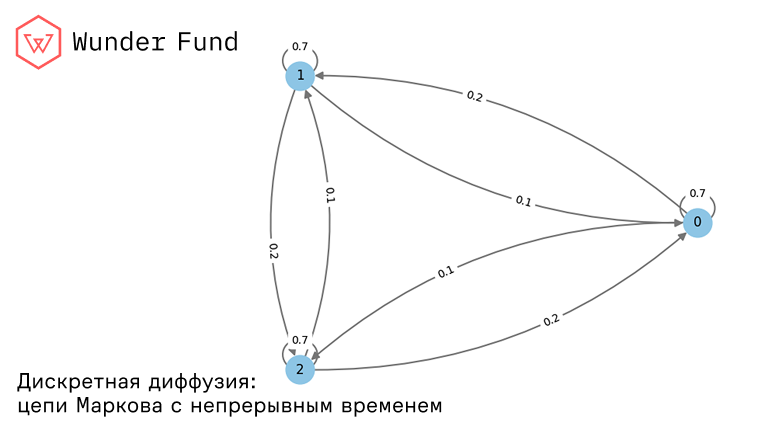
Этот материал, задуманный как первый в серии статей о дискретных диффузионных моделях, уже несколько месяцев лежал у меня в черновиках. Выход модели Gemini Diffusion от Google показался мне отличным поводом наконец его опубликовать. Цепи Маркова с дискретным временем — это последовательности случайных величин, в которых прошлое и будущее условно независимы при известном настоящем. Они достаточно хорошо известны в машинном обучении. А вот непрерывные аналоги этих цепей встречаются гораздо реже. Подобные модели фигурируют в исследованиях по дискретным диффузионным моделям (вот, вот и вот — далеко не полный список публикаций на эту тему). Поэтому мне показалось, что можно вернуться к блогу и написать о цепях Маркова с непрерывным временем, а может быть, и подготовить целый цикл публикаций.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Sandflow открыла датасет из 106 тысяч 3D‑моделей
AI-агентыHabr AI

Sandflow открыла датасет из 106 тысяч 3D‑моделей

Французский стартап Sandflow выпустил Sand3D — открытый датасет и 106 тыс. 3D‑моделей различных объектов. Каждая модель сопровождается кодом на Python, который строит объект из независимых деталей. Датасет предлагают использовать для обучения моделей создавать и редактировать 3D‑модели.

Обложка: Пять футурологических сценариев сосуществования человека и искусственного разума
AI-агентыHabr AI

Пять футурологических сценариев сосуществования человека и искусственного разума

Представим, что ИИ уже умеет выполнять любую работу, получил юридические права и тела роботов. Кто тогда владеет фабриками, принимает последнее решение и остается автором будущего? Разбираем пять устойчивых обществ и два предела, за которыми сосуществовать уже некому.

Обложка: ASR для AI-разработки: как я замерял качество распознавания технических терминов
AI-агентыHabr AI

ASR для AI-разработки: как я замерял качество распознавания технических терминов

В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот?

