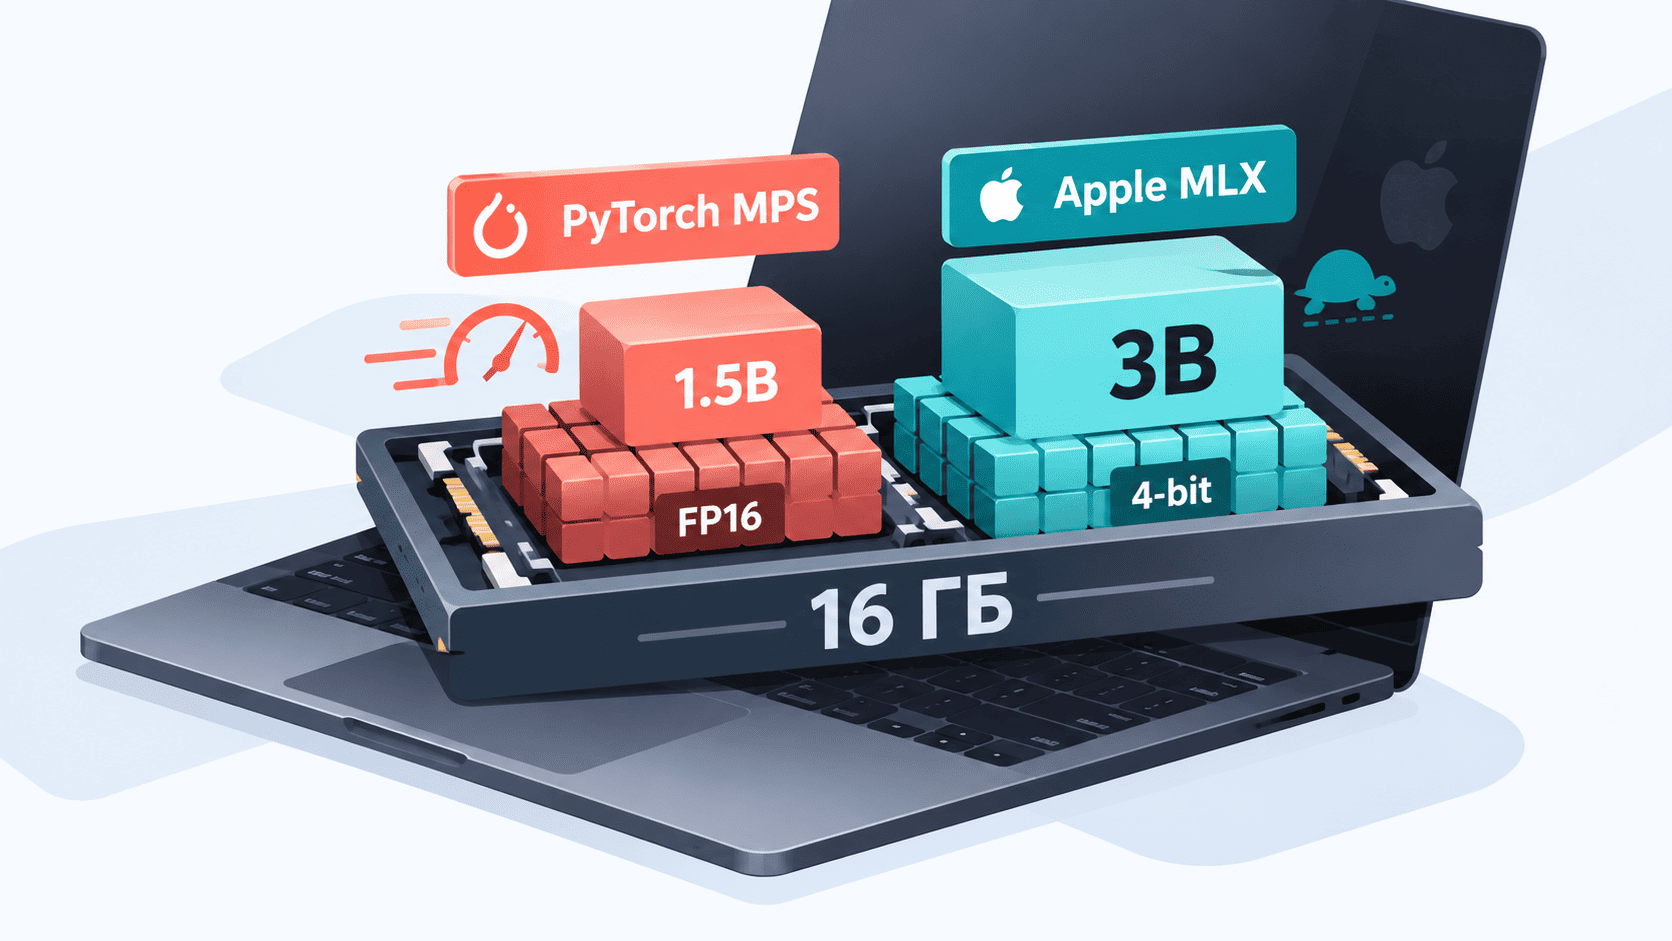
Apple MLX создавался для эффективной работы с моделями на Apple Silicon, но при дообучении он может оказаться в несколько раз медленнее PyTorch MPS. Зато там, где MPS упирается в ограничения памяти, MLX позволяет запустить модель вдвое крупнее. Откуда берётся такой разрыв, насколько виновато квантование и какой стек выбрать для локального SFT? Ответы дают 10 запусков Qwen 2.5 с разными размерами моделей и длиной контекста. Изучить бенчмарки
Читать далееAI-агенты
[Перевод] PyTorch MPS против Apple MLX: как дообучать LLM на Mac с 16 ГБ и что выбрать