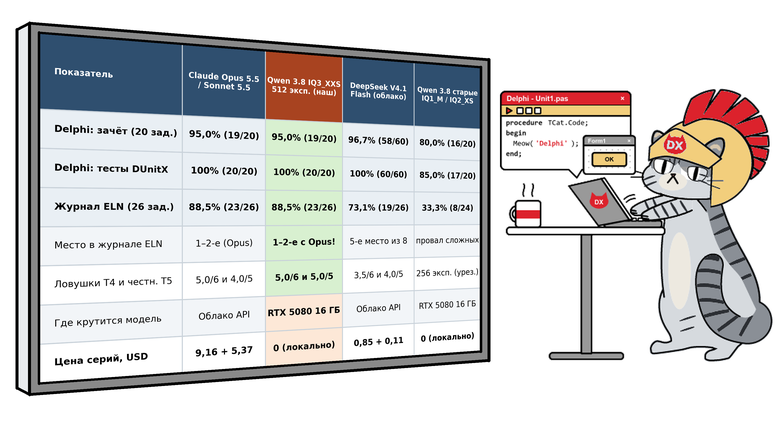
В двух предыдущих статьях мы проверяли языковые модели на наших повседневных задачах: работе с данными в электронном лабораторном журнале и исправлении ошибок в трёх закрытых проектах на Delphi — от программы рентгеновской рефлектометрии X-Ray Calc до нашей системы управления лабораторией. В обоих тестах локальные модели на моей рабочей станции (одна карта RTX 5080 на 16 ГБ и 62 ГБ оперативной памяти) заметно отставали от облачных лидеров. На вопросах по журналу ранняя сборка Qwen 3.8 IQ2_XS набрала жалкие 33% (8 из 24), а gpt-oss-20b — 40%. На задачах Delphi специализированная Qwen 3.8 Coder IQ1_M взяла 16 задач из 20 (80%). Результат уже вполне рабочий, но до Claude Sonnet 5.5 (19/20) она всё-таки не дотянула. Конечно, можно было на этом успокоиться и списать отставание на скромные 16 гигабайт видеопамяти.
Читать далееПродажи
Помогаем малышке стать сильной: локальная Qwen против облачных флагманов на 16 ГБ видеопамяти