Продажи

Пять решений для 1С: ИИ-агент, диагностика базы и согласование платежей

Обложка: Пять решений для 1С: ИИ-агент, диагностика базы и согласование платежей

В октябрьскую подборку Инфостарт Маркетплейса вошли пять инструментов для работы с данными, платежами, отпусками и продажами. Разберём, как они устроены, какие конфигурации поддерживают и какие ограничения нужно учитывать перед установкой.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Как я каждый месяц проверяю, называет ли меня ChatGPT, и что из советов по GEO на деле не работает
ПродажиHabr AI

Как я каждый месяц проверяю, называет ли меня ChatGPT, и что из советов по GEO на деле не работает

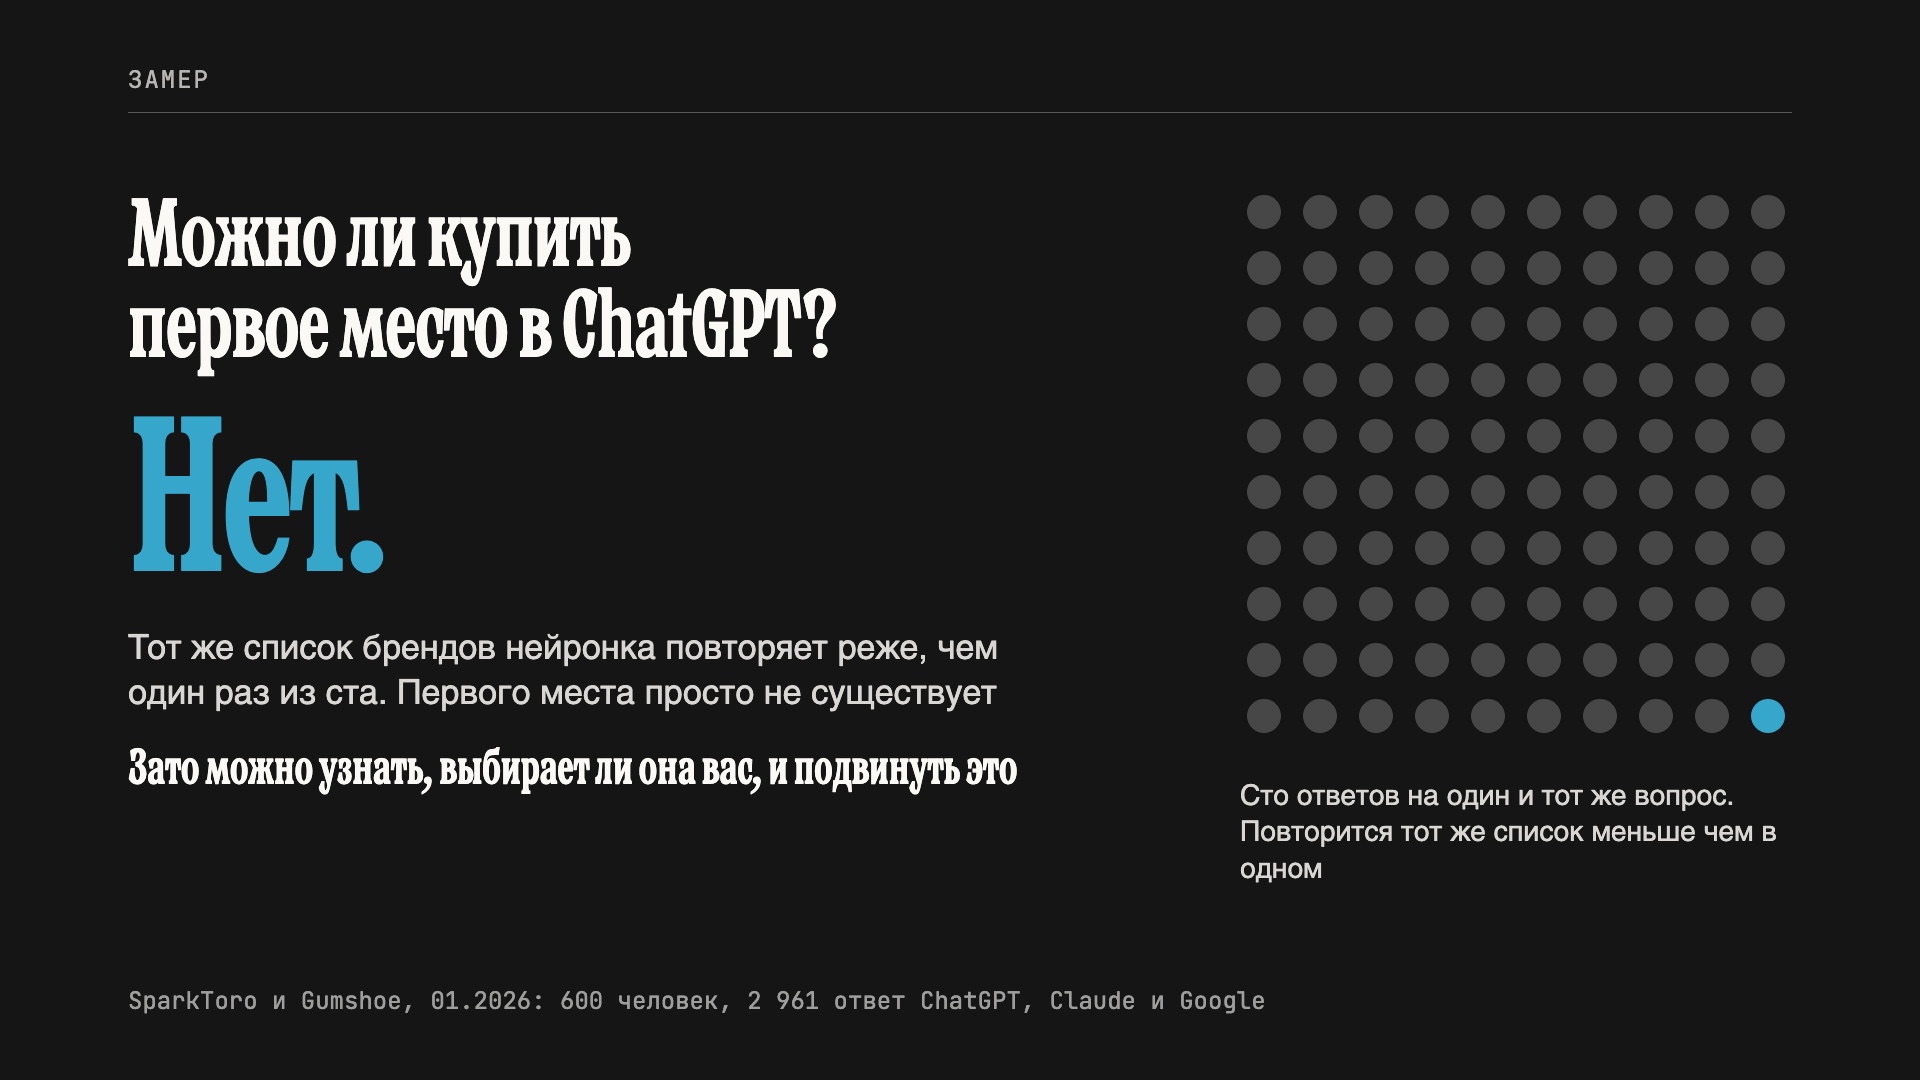
С августа у меня работает скрипт, который задает нейронке вопросы так, как их задал бы мой клиент, и считает, называет ли она меня. Сейчас он делает это раз в месяц. Рассказываю, как это устроено, что показали замеры и почему популярные советы вроде llms.txt почти ничего не дают. 5 ноября я читал лекцию «Бренд, который выбирает нейронка» на площадке МосХаб.Сколково, в цикле экспертных вебинаров РАСО и НИУ ВШЭ для студентов рекламы и PR. Там была маркетинговая часть. Здесь техническая: как устроен замер и что пришлось в нем переделать по дороге.

Обложка: Microsoft разрабатывает ИИ‑инструмент для редактирования речи во время прямой трансляции
ПродажиHabr AI

Microsoft разрабатывает ИИ‑инструмент для редактирования речи во время прямой трансляции

Microsoft разрабатывает ИИ‑систему, которая сможет редактировать речь человека во время прямой трансляции. Компания подала патентную заявку, где описывается инструмент, способный распознавать определённые слова в аудиопотоке трансляции и заменять их другими.

ПродажиHabr ML

Неделю гонял 14 локальных LLM на мини-ПК с Ryzen AI Max+ 395. Цифры, грабли и что я оставил себе

Машина GMKtec EVO-X2 на 96 ГБ, Ubuntu 26.04, LM Studio, кванты Q4. В отборочном круге было 12 моделей. В финал вышли четыре лидера и два новых претендента, которых я докачал уже после отбора, так что всего через тесты прошло 14. Qwen3.8 27B выдаёт 12,8 токена в секунду, а Gemma 4 26B A4B на том же железе 63, хотя файлы у них почти одного размера. Размер окна контекста на скорость и баллы не повлиял, если запрос один и тот же. А вот длинный контекст модели читают минутами, 200K токенов занимают от 8 до 23 минут. На длинном контексте лучше всех отработала Qwen3.8, и это главная причина, по которой она у меня осталась. В памяти теперь постоянно подгружены две модели. Gemma 4 26B Uncensored отвечает в разговорном боте, Qwen3.8 27B с MTP берёт задачи сложнее и фоновую работу.