Кейсы

Пытаемся сделать лаборанта из локальной Qwen 3.8 на 16 ГБ VRAM
Обложка: Пытаемся сделать лаборанта из локальной Qwen 3.8 на 16 ГБ VRAM
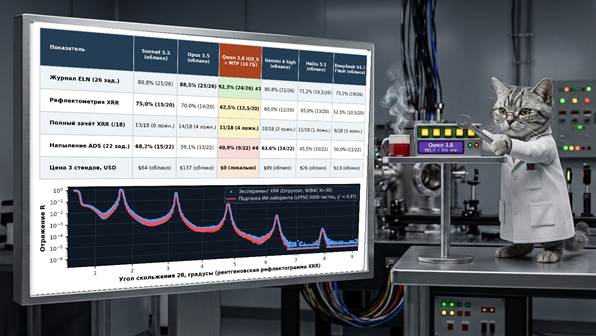
В прошлой статье мы запустили локальную Qwen 3.8 на машине с одной картой RTX 5080 на 16 ГБ. На вопросах по лабораторному журналу она обошла даже Claude Opus 5.5. Но радость оказалась преждевременной, потому как поиск по базе — самая простая часть работы физика. Когда мы проверили модель ещё на двух стендах: в обратной задаче рентгеновской оптики (XRR) и за пультом вакуумной установки (ADS), результат сильно упал. Пришлось разбираться, почему при переходе от таблиц к физике и «железу» мелкая модель начинает сыпаться.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Как мы убрали человека из код-ревью (но пока не везде)
КейсыHabr AI

Как мы убрали человека из код-ревью (но пока не везде)

Привет, Хабр! Меня зовут Анна Саботович, я веду внедрение AI-ревьюера в продуктовой группе Garage Eight, и самый частый вопрос, который мне задают: «Ну и когда он заменит человека?» Отвечу сразу: на части кода уже заменил. В октябре наши iOS-команды сняли третий обязательный апрув на merge request (MR). Теперь в продуктовых репозиториях их не больше двух, при этом в репозитории ревьюера за тот же октябрь влили 35 MR, и апрув кого-то, кроме автора, есть только у шести. Во внутреннем сервисе аналитики разработки влили 69 MR, и ни в одном нет апрува другого человека: автор мержит сам. Хочу рассказать, как мы учились доверять AI и что планируем делать дальше.

Обложка: Научили ИИ перестраивать расписание авиарейсов в непредсказуемых ситуациях: реальный кейс
КейсыHabr AI

Научили ИИ перестраивать расписание авиарейсов в непредсказуемых ситуациях: реальный кейс

Разработали AI-инструменты для известной российской авиакомпании, которые помогают сотрудникам принимать решения, когда что-то идет не по плану. Рассказываем, как отработала система, когда мы прогнали её на реальном сбое.

Обложка: Виртуальные сотрудники и агенты на митапе «Русское техно 2»
КейсыHabr AI

Виртуальные сотрудники и агенты на митапе «Русское техно 2»

У многих настроен свой локальный харнесс, другие работают в облаке. А что если развернуть харнесс на большую компанию? Как быть, если первого ответа агента приходится ждать почти 40 секунд? Что можно оптимизировать и к чему это приведет? Ладно, развернули и оптимизировали, но как подружить агентов с сотрудниками? И как оценить эффект от внедрения ИИ на уровне бизнеса? Я еще не настроил свой харнесс, и мне было интересно посмотреть на опыт других компаний. Поэтому пошел на митап MWS на эту тему. Сначала рассказали историю развития ИИ-агентов и базу: что такое обвязка вокруг модели. Потом был доклад про оптимизацию: в MWS все развернуто на Kubernetes и поддерживает OpenClaw и Hermes одновременно. Дальше руководители направлений обсуждали, как агенты работают вместе с сотрудниками. Напоследок был доклад про внедрение ИИ в организациях и оценку его эффекта.