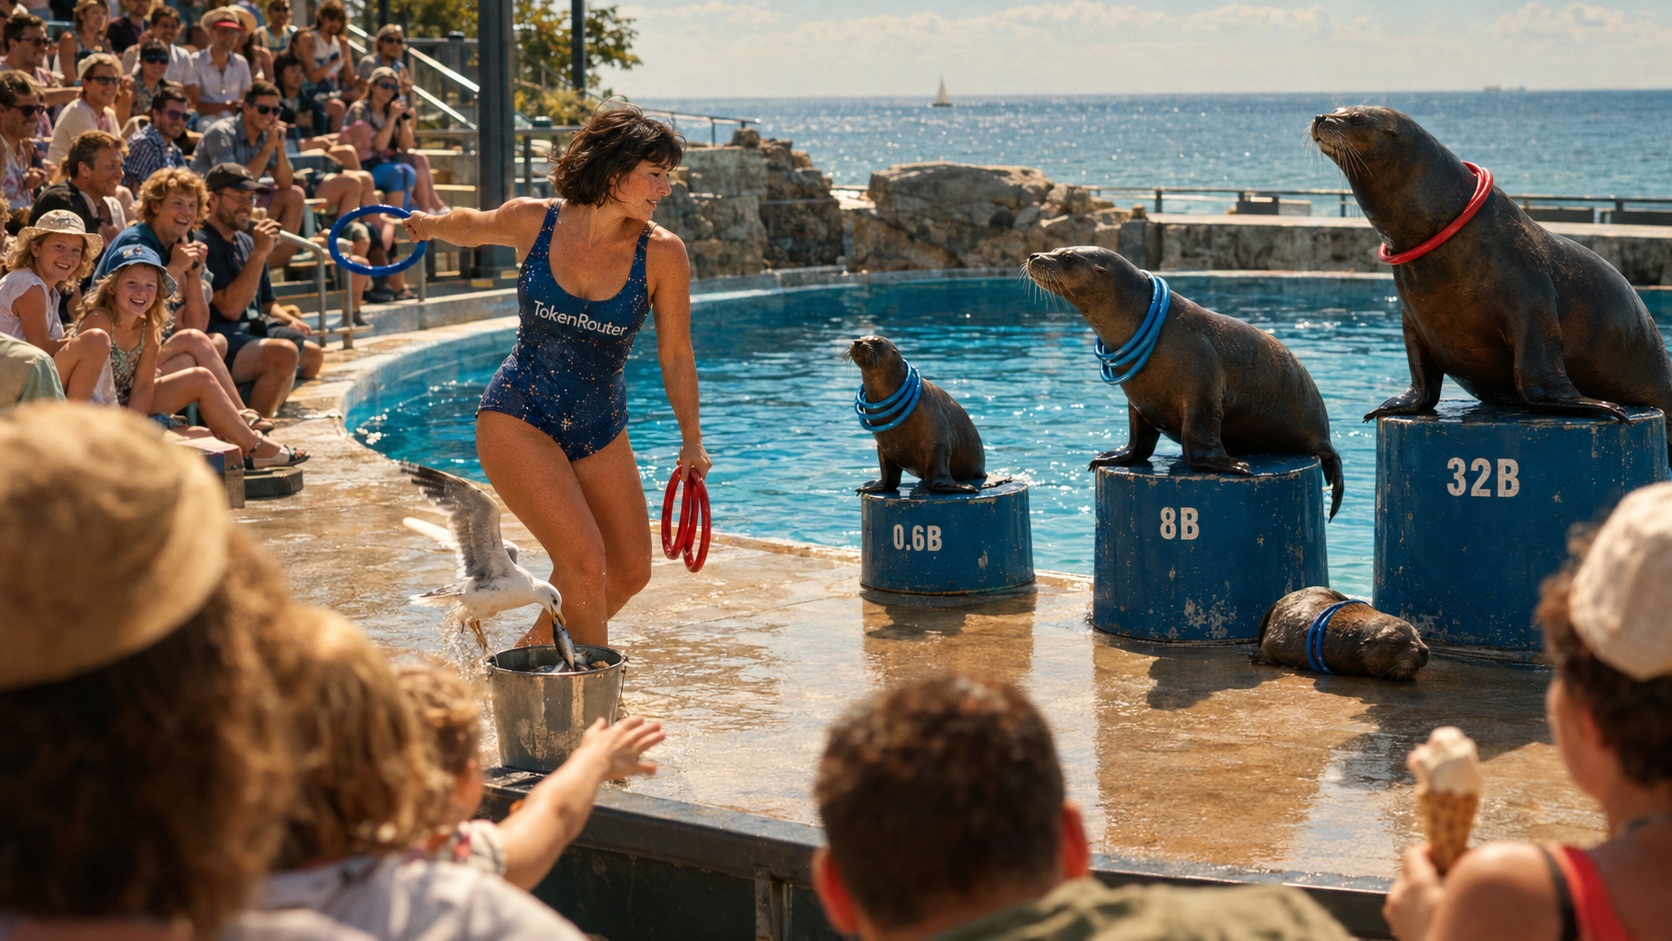Привет, Хабр! Сегодня расскажу, как можно эффективно использовать в своей системе сразу несколько LLM. ИИ решает самые разные задачи: анализирует тексты, готовит контент, обрабатывает изображения, генерирует видео. Но одна LLM все запросы не тянет. Точнее, тянет, только результат получается хуже, чем мог бы. Технические запросы, такие как расчет гармоник, разбор спецификаций, интерпретацию стандартов — лучше поручать специализированной модели, которая уверенно работает с формулами и таблицами. А общие — универсальной. Для эффективного направления запросов используется маршрутизация LLM, и здесь речь идет не о сетевом трафике. Запросы перераспределяются между разными моделями, сдвигая границу Парето «стоимость–качество» обслуживания. В результате можно выбрать, какую именно модель нам будет выгоднее использовать в каждом конкретном случае.
Читать далееМаркетинг
TokenRouter: непрерывная маршрутизация LLM по токенам