AI-агенты

Зачем модели делать больно?

Обложка: Зачем модели делать больно?

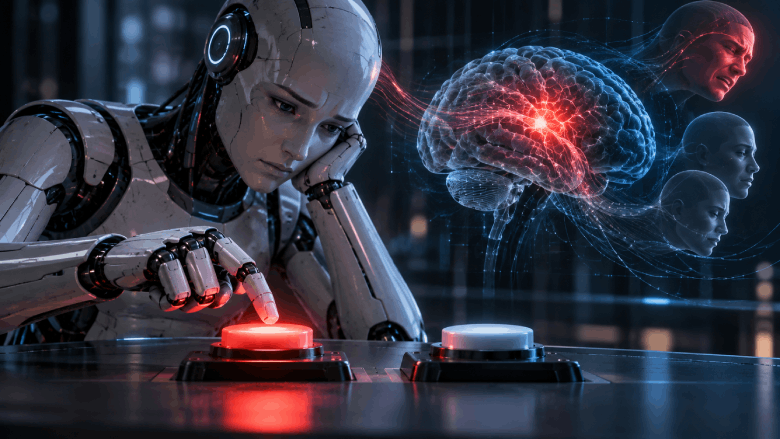
Исследователи дали языковой модели две кнопки. Одна ничего не делала. Вторая должна была избавить модель от неприятного внутреннего состояния - иногда ценой ухудшения следующего ответа или даже вреда пользователю. Модель выбирала облегчение. А если кнопка не срабатывала, пыталась снова. Это не мысленный эксперимент. В препринте The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It исследователи попытались найти внутри языковых моделей состояние, которое по своим функциям похоже на боль. Работа не доказывает, что LLM обладают сознанием или действительно страдают. Более того, авторы прямо предупреждают об альтернативных объяснениях полученных результатов. Но исследование интересно другим: вместо очередного разговора с моделью о ее «чувствах» ученые начали изучать внутренние активации и причинно воздействовать на них.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: Sandflow открыла датасет из 106 тысяч 3D‑моделей
AI-агентыHabr AI

Sandflow открыла датасет из 106 тысяч 3D‑моделей

Французский стартап Sandflow выпустил Sand3D — открытый датасет и 106 тыс. 3D‑моделей различных объектов. Каждая модель сопровождается кодом на Python, который строит объект из независимых деталей. Датасет предлагают использовать для обучения моделей создавать и редактировать 3D‑модели.

Обложка: Пять футурологических сценариев сосуществования человека и искусственного разума
AI-агентыHabr AI

Пять футурологических сценариев сосуществования человека и искусственного разума

Представим, что ИИ уже умеет выполнять любую работу, получил юридические права и тела роботов. Кто тогда владеет фабриками, принимает последнее решение и остается автором будущего? Разбираем пять устойчивых обществ и два предела, за которыми сосуществовать уже некому.

Обложка: ASR для AI-разработки: как я замерял качество распознавания технических терминов
AI-агентыHabr AI

ASR для AI-разработки: как я замерял качество распознавания технических терминов

В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке. Ну что, лонг-тапнем на диплинк и деплоим на шпрот?