AI-агенты

Дообучил Qwen3.6 синтаксису 1С и проверил её на случайных вопросах: все результаты не ниже 95 %
Обложка: Дообучил Qwen3.6 синтаксису 1С и проверил её на случайных вопросах: все результаты не ниже 95 %
Летом я дообучал Qwen3.6 27B на справочном материале по 1С и проверял результат субьективно на глаз: по ответам на последние добавленные объекты и доработанные методы. Позднее решил узнать точно, какие данные не усвоились при дообучении. В результате сделал нормальный тест: случайные сто вопросов из ~ 20 тысяч записей, ответы дообученной модели, два LLM-судьи и детерминированная проверка критичных полей. Всего 6 прогонов по 100 вопросов. Все результаты — не ниже 95 % корректных ответов. В эти проценты я зачислил и ответы с некритичными потерями: потерянный пример кода или переформулированное описание при точной сигнатуре — это не та ошибка, из-за которой падает код. Как я пришёл к этой методике и почему первые прогоны пришлось выбросить — ниже.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: От чата до тёмной фабрики: шесть уровней ИИ в разработке и почему мы остановились на L4
AI-агентыHabr AI

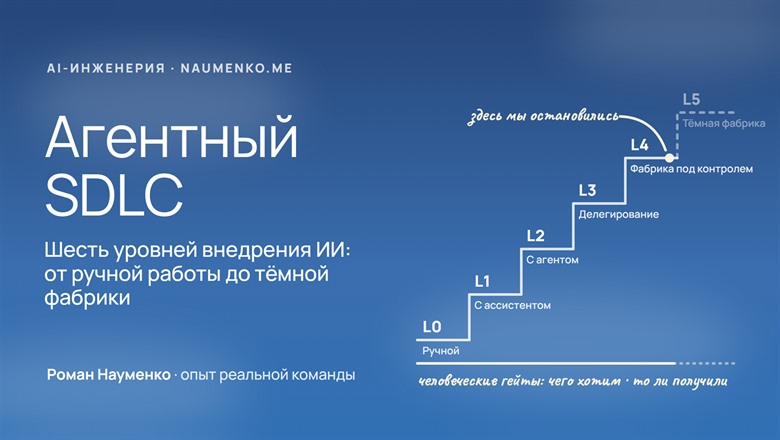
От чата до тёмной фабрики: шесть уровней ИИ в разработке и почему мы остановились на L4

Больше года я внедряю ИИ в разработку зрелой SaaS-компании, вместе со сложившейся инженерной командой, которая поначалу относилась к ИИ скептически. Мы прошли большой путь: от копирования кода из ИИ-чата до того, что отдаём агентам разработку фич целиком. Мы не занимаемся вайб-кодингом и не делаем продукт за вечер одним промптом. То, чем мы занимаемся, я называю AI-инженерией: мы строим систему, которая стабильно выдаёт результат по нашим стандартам качества. Сейчас мы экспериментируем с полуавтономной агентной фабрикой в облаке. Этот путь я разложил на шесть уровней, от привычной ручной разработки до «тёмной фабрики». Ниже — как меняется жизненный цикл разработки на каждом уровне, как понять, где сейчас ваша команда, и что нужно, чтобы двигаться дальше.

Обложка: Клодизмы. Часть 1. Классификация ошибок, которые языковая модель допускает в связном тексте
AI-агентыHabr AI

Клодизмы. Часть 1. Классификация ошибок, которые языковая модель допускает в связном тексте

Я преподаю английский язык с 1989 года и веду сайт e-repa.ru: упражнения для русскоязычных учеников, построенные на собственных js-движках. О самих js-движках я писал в отдельной серии (часть 1, часть 2). Тексты к упражнениям — объяснения, преамбулы, методические записки — я пишу вместе с Claude. За несколько месяцев такой работы у меня накопился длинный список ошибок, которые модель повторяет из текста в текст с таким постоянством, что я называю их клодизмами. Как такой список возникает, покажу на примере одного задания.

Обложка: «Уязвимости нет, и мы её исправили»: первая неделя HTML-виджетов в Telegram
AI-агентыHabr AI

«Уязвимости нет, и мы её исправили»: первая неделя HTML-виджетов в Telegram

Недавно я писал статью о том как работают HTML-виджеты Telegram. На следующий день после ее выхода исследователи показали, как через виджет запустить калькулятор на Android. Павел Дуров заявил, что проблемы нет, а сценарий уже исправлен. Разбираемся, что сломалось, какие нейросети помогли найти баги и в какие версии Telegram попали исправления.