AI-агенты

Grok 4.7, GPT-6 Astra, Claude и китайские модели, кто эффективнее?
Обложка: Grok 4.7, GPT-6 Astra, Claude и китайские модели, кто эффективнее?
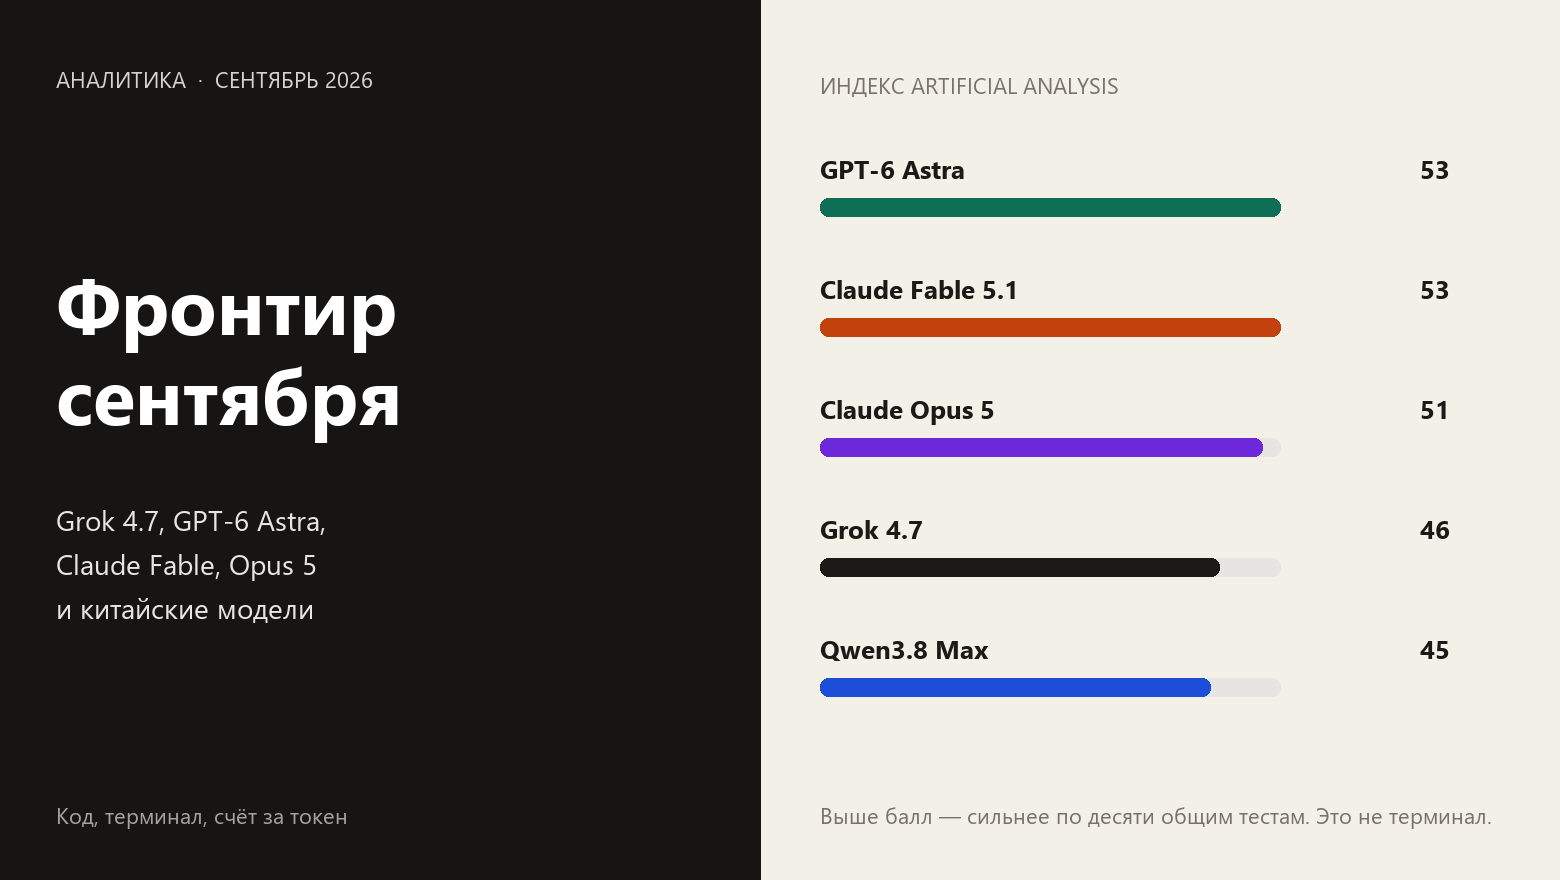
Вчера SpaceXAI выложила Grok 4.7. За три недели до этого OpenAI выпустила GPT-6 Astra, Anthropic — Claude Fable 5.1. Ещё в июле рядом встал Claude Opus 5: сама Anthropic пишет, что для большинства задач включать надо его, а Fable доставать, когда Opus уже не тянет ваши замеры. Китайские лаборатории в этой компании больше не «дешёвый запасной аэродром». Qwen3.8 Max стоит те же $2 и $6 за миллион токенов, что и Grok, и на общем индексе отстаёт на один балл. Kimi K3 на суточных инженерных задачах сидит в том же коридоре, что и свежий Grok. Ниже один набор работ: длинный код, терминал, схемы, юридические дела и счёт. Цифры лабораторий и независимый прогон Artificial Analysis лежат отдельно. На Terminal‑Bench они расходятся почти в полтора раза. Спорить «кто первый» по одной картинке из анонса после этого бесполезно.

Читать далее

ZOLT JOURNAL / ДАЛЬШЕ

Обложка: От чата до тёмной фабрики: шесть уровней ИИ в разработке и почему мы остановились на L4
AI-агентыHabr AI

От чата до тёмной фабрики: шесть уровней ИИ в разработке и почему мы остановились на L4

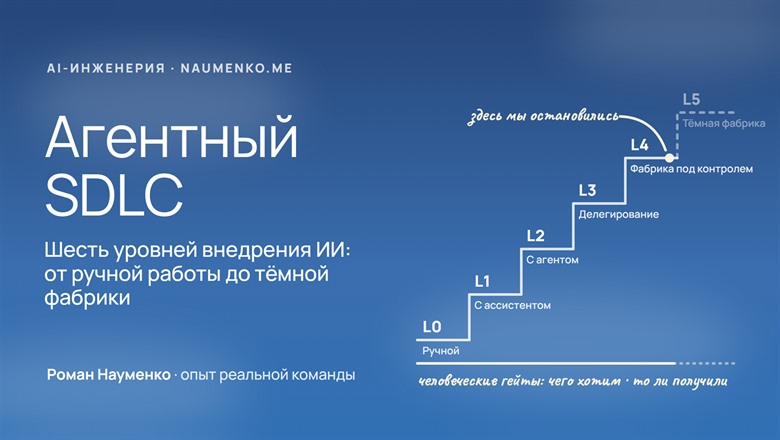
Больше года я внедряю ИИ в разработку зрелой SaaS-компании, вместе со сложившейся инженерной командой, которая поначалу относилась к ИИ скептически. Мы прошли большой путь: от копирования кода из ИИ-чата до того, что отдаём агентам разработку фич целиком. Мы не занимаемся вайб-кодингом и не делаем продукт за вечер одним промптом. То, чем мы занимаемся, я называю AI-инженерией: мы строим систему, которая стабильно выдаёт результат по нашим стандартам качества. Сейчас мы экспериментируем с полуавтономной агентной фабрикой в облаке. Этот путь я разложил на шесть уровней, от привычной ручной разработки до «тёмной фабрики». Ниже — как меняется жизненный цикл разработки на каждом уровне, как понять, где сейчас ваша команда, и что нужно, чтобы двигаться дальше.

Обложка: Клодизмы. Часть 1. Классификация ошибок, которые языковая модель допускает в связном тексте
AI-агентыHabr AI

Клодизмы. Часть 1. Классификация ошибок, которые языковая модель допускает в связном тексте

Я преподаю английский язык с 1989 года и веду сайт e-repa.ru: упражнения для русскоязычных учеников, построенные на собственных js-движках. О самих js-движках я писал в отдельной серии (часть 1, часть 2). Тексты к упражнениям — объяснения, преамбулы, методические записки — я пишу вместе с Claude. За несколько месяцев такой работы у меня накопился длинный список ошибок, которые модель повторяет из текста в текст с таким постоянством, что я называю их клодизмами. Как такой список возникает, покажу на примере одного задания.

Обложка: «Уязвимости нет, и мы её исправили»: первая неделя HTML-виджетов в Telegram
AI-агентыHabr AI

«Уязвимости нет, и мы её исправили»: первая неделя HTML-виджетов в Telegram

Недавно я писал статью о том как работают HTML-виджеты Telegram. На следующий день после ее выхода исследователи показали, как через виджет запустить калькулятор на Android. Павел Дуров заявил, что проблемы нет, а сценарий уже исправлен. Разбираемся, что сломалось, какие нейросети помогли найти баги и в какие версии Telegram попали исправления.